
В редакторе документ выглядит как последовательный текст, но внутри DOCX — архив с XML-файлами и связями между ними. Word может разбить одно имя на несколько фрагментов разметки. Телефон бывает в колонтитуле, комментарии или свойствах документа. Если искать и заменять строки только в основном тексте, часть данных останется; если править архив без учёта его структуры, готовый файл может перестать открываться.
Поэтому я строил Doclear вокруг разбора OOXML-пакета. Ядро открывает DOCX, собирает текстовые блоки из поддерживаемых частей и запоминает, где найденный фрагмент находится в исходной разметке. Отдельно оно инвентаризирует части, которые не может считать проверенным текстом: изображения, вложения, внешние связи. Интерфейс на React показывает человеку результат этого разбора, но сам не переписывает XML.
Один документ остаётся в браузере
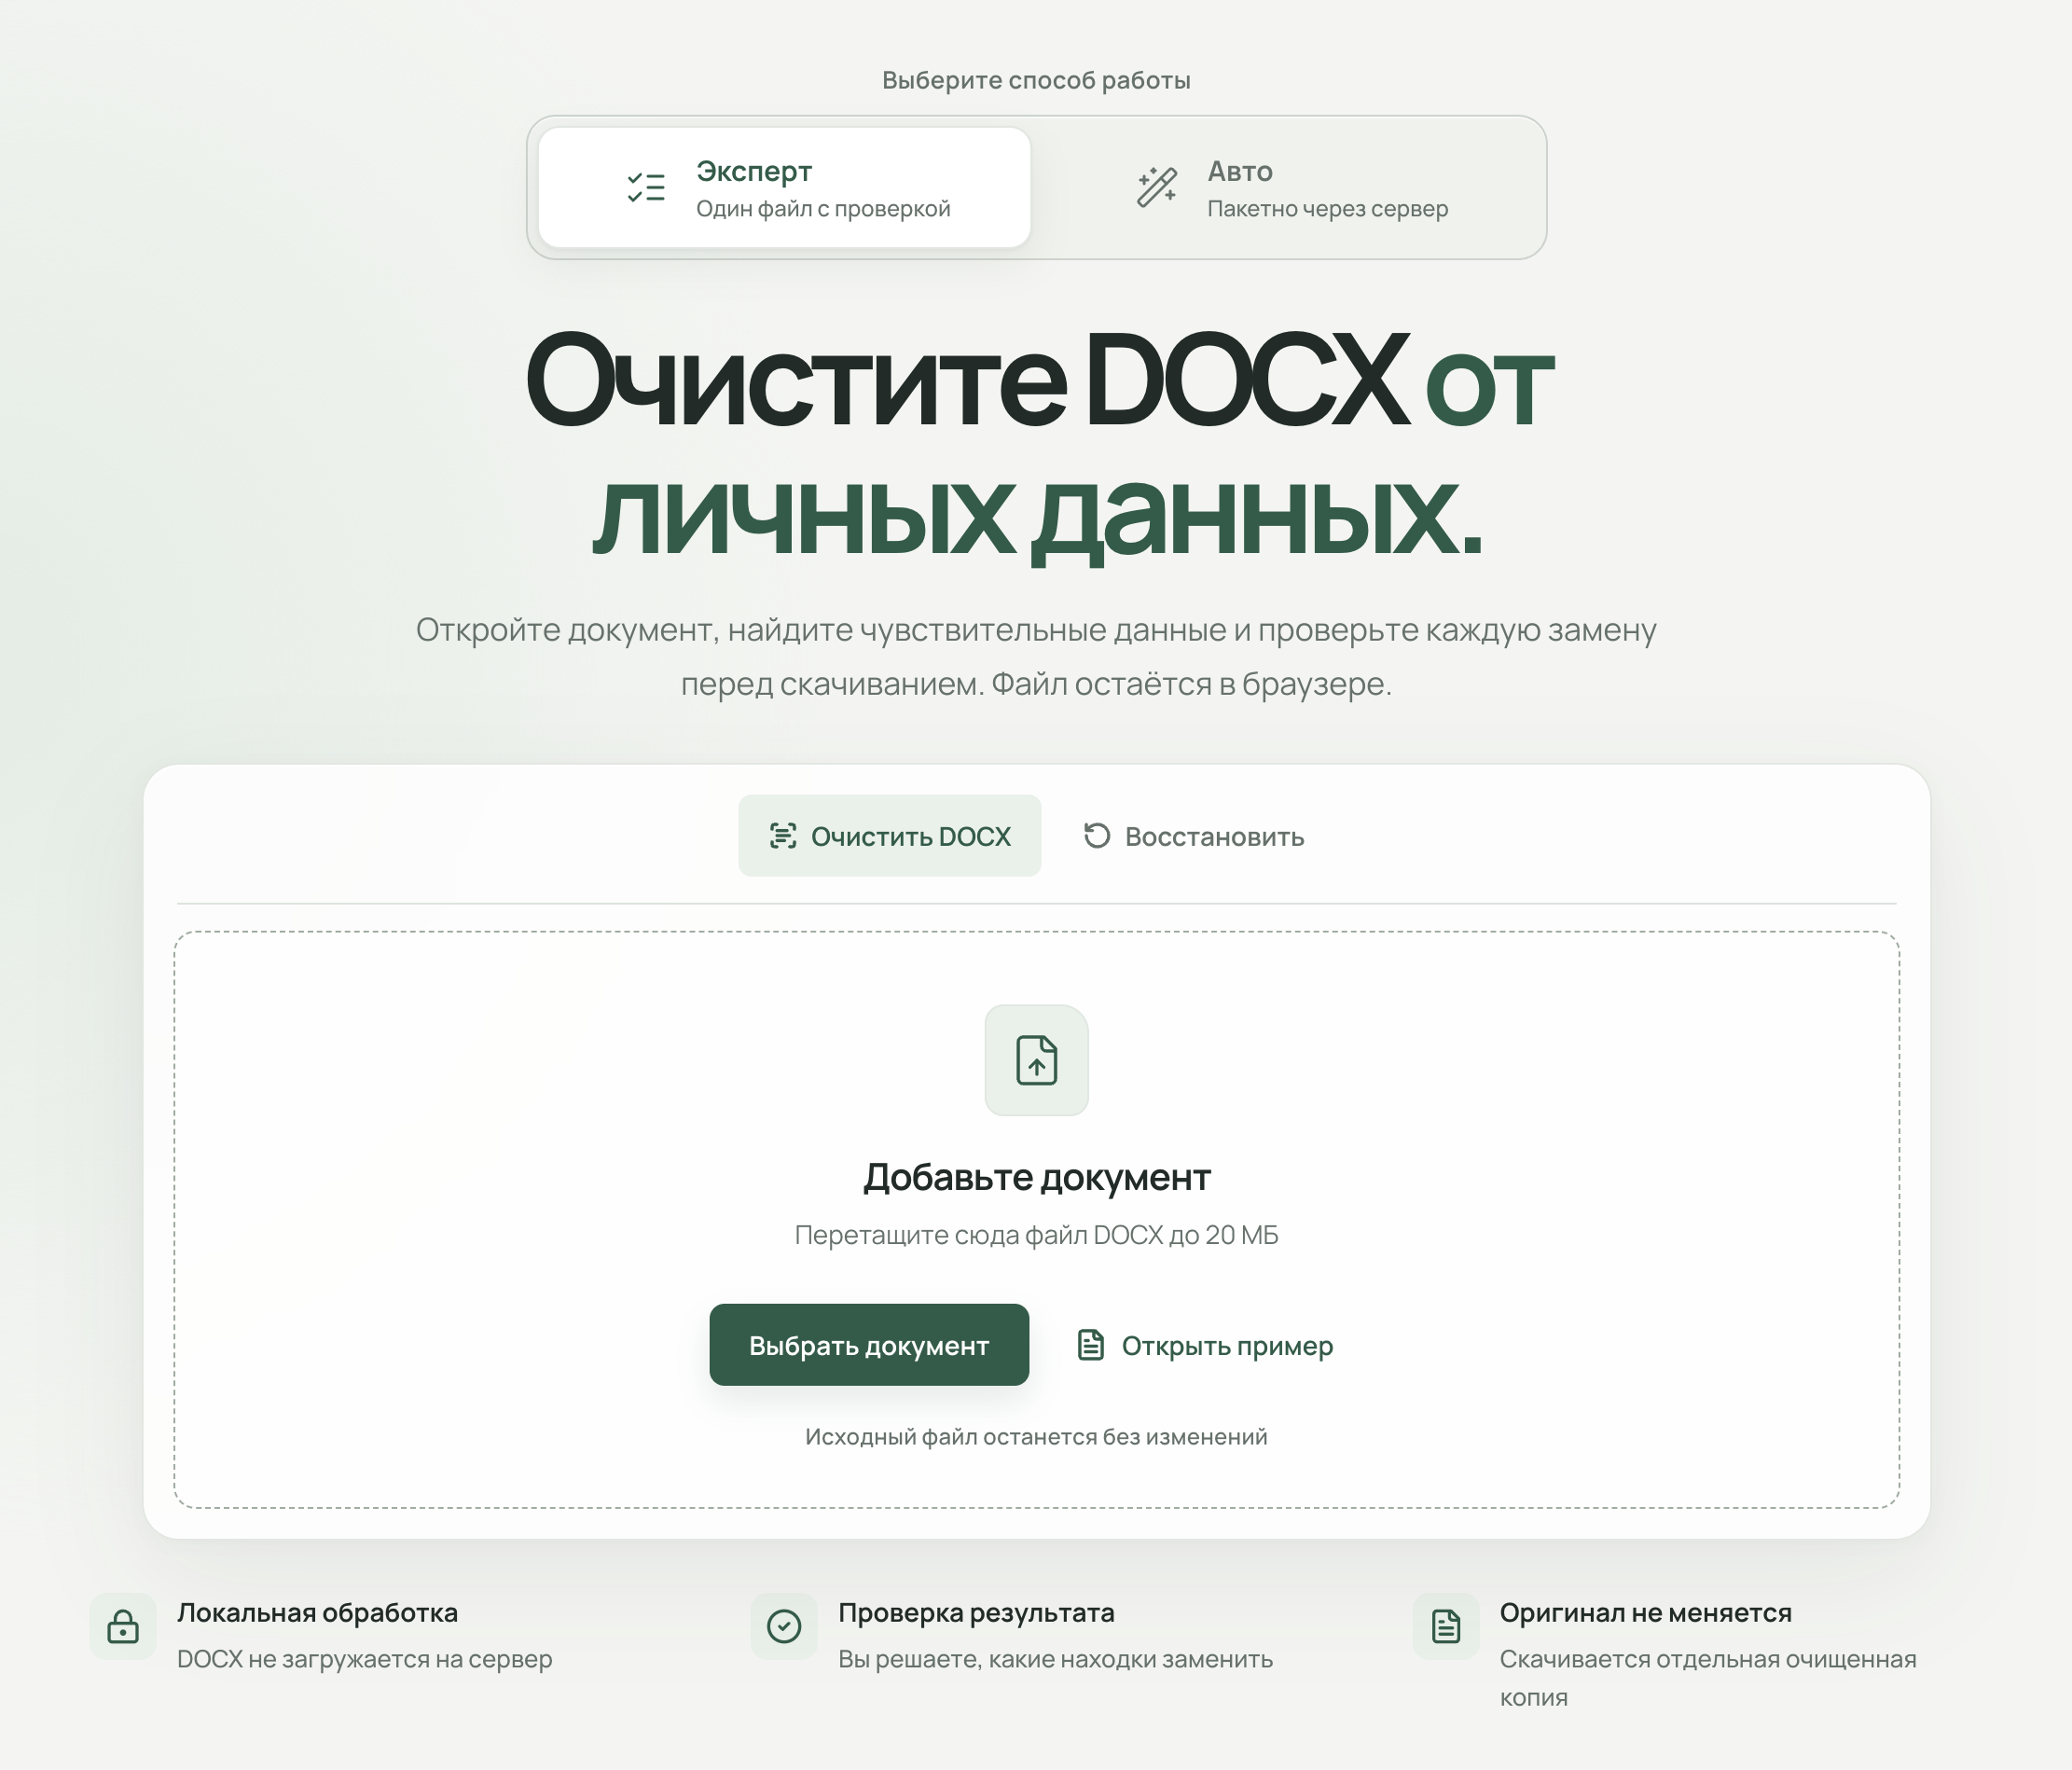
В режиме «Эксперт» файл читается и собирается заново в Web Worker. Его байты и извлечённый текст не отправляются в API обработки документов. Worker принимает отдельные команды на открытие, поиск и генерацию файла; для долгой операции есть прогресс и отмена. Такой путь подходит, когда нужно посмотреть каждую находку и решить, какую из них заменять.
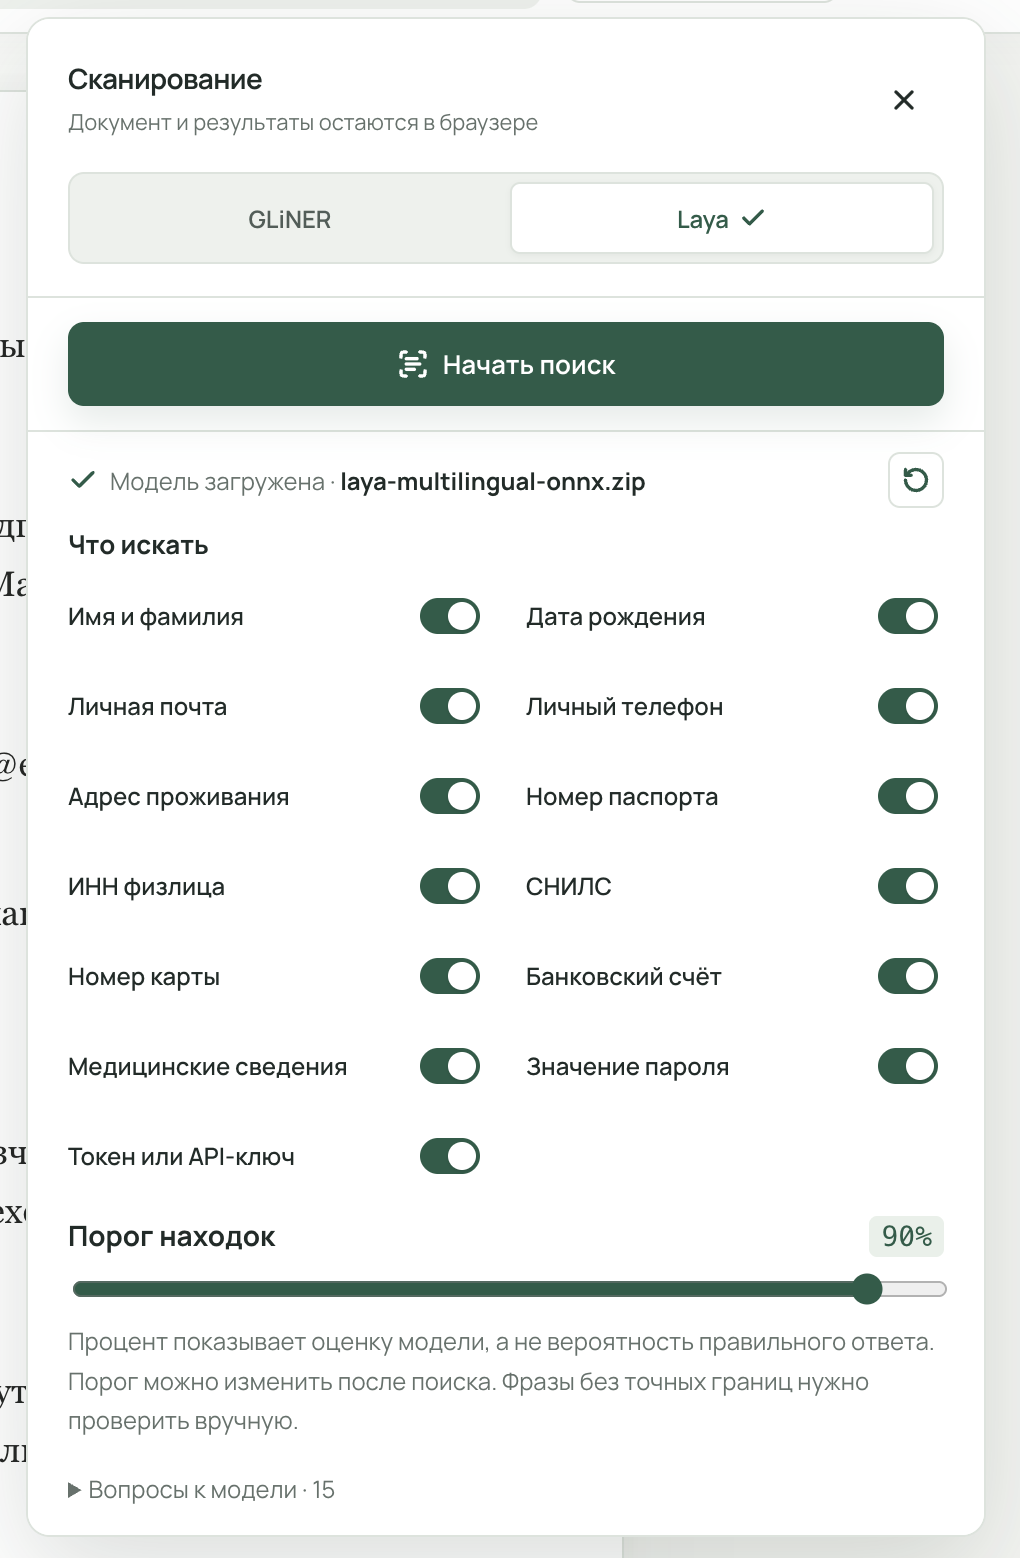
Поиск предлагает кандидатов, а выбор остаётся за человеком. Для ручной проверки можно выделить фрагмент в документе или ввести точную строку поиска. Дополнительные модели Laya и GLiNER запускаются в браузере после выбора их архивов; их подсказки тоже нужно подтвердить. Модель может узнать категорию, но не всегда точно указать границы значения, поэтому неоднозначный результат нельзя автоматически превращать в замену.
Перед сканированием можно выбрать модель, категории данных и порог оценки. Процент рядом с находкой показывает оценку модели, а не вероятность того, что она права. Даже при высоком пороге фрагменты нужно прочитать в контексте документа.
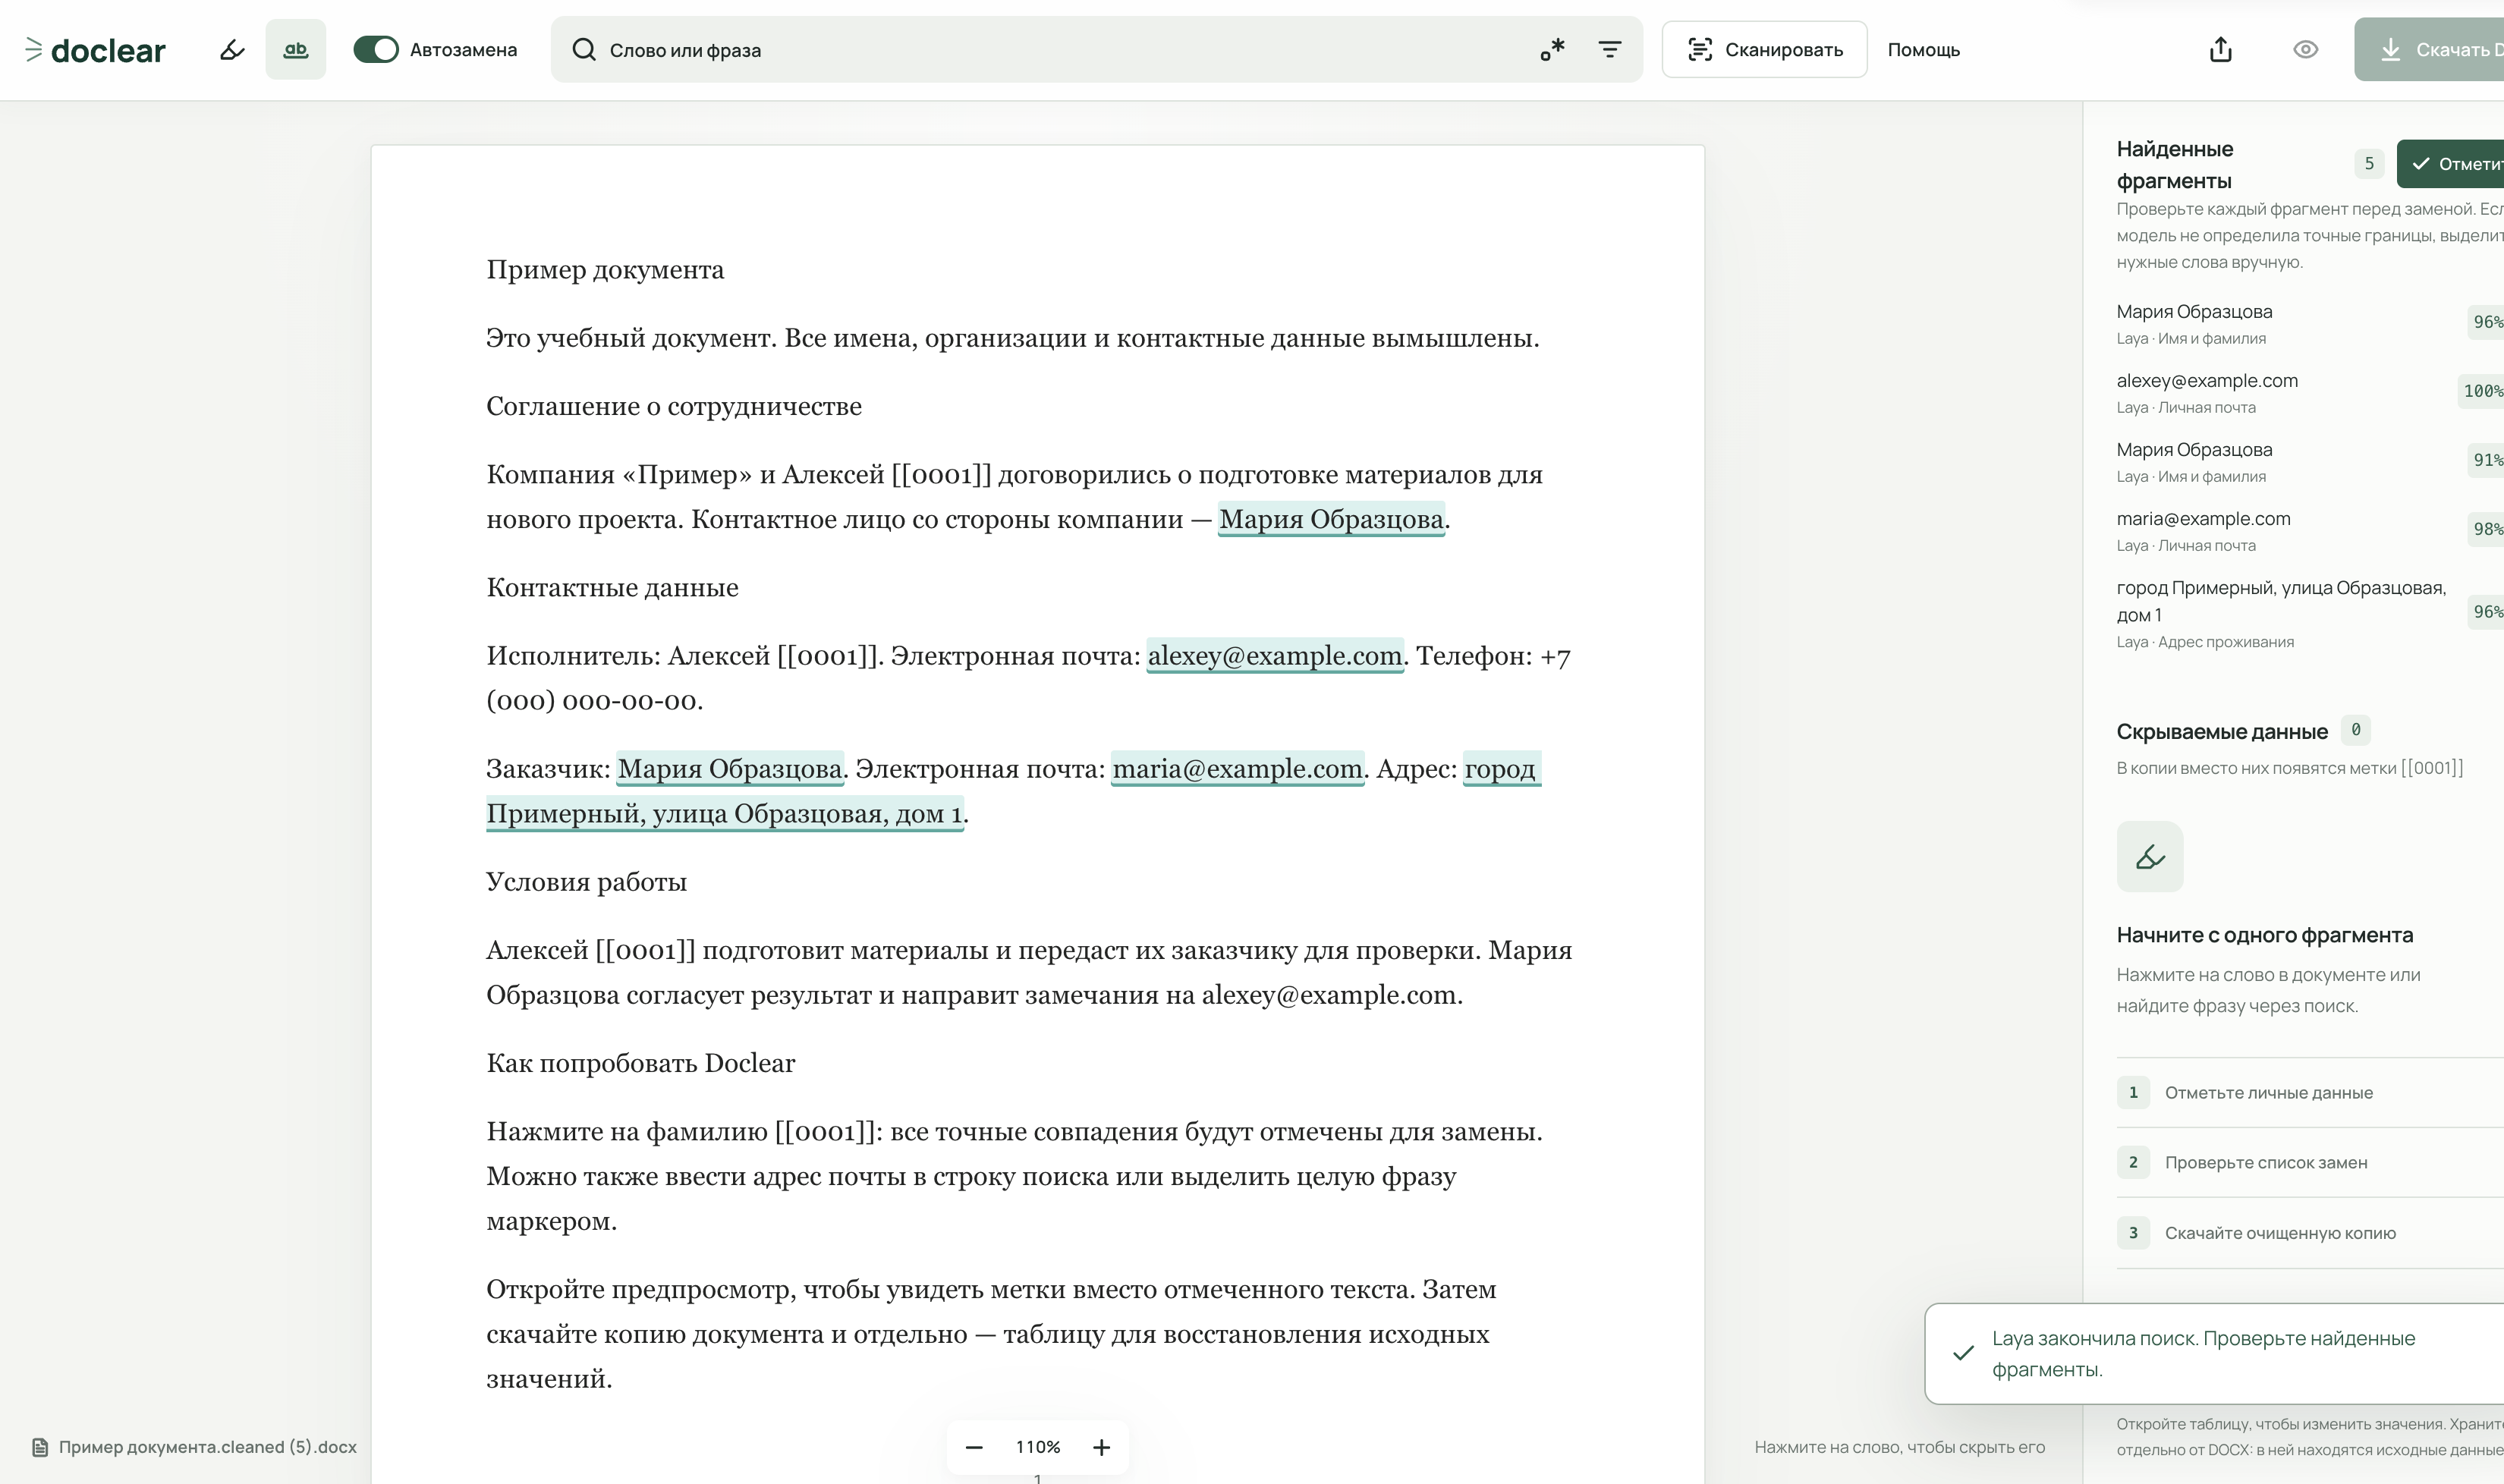
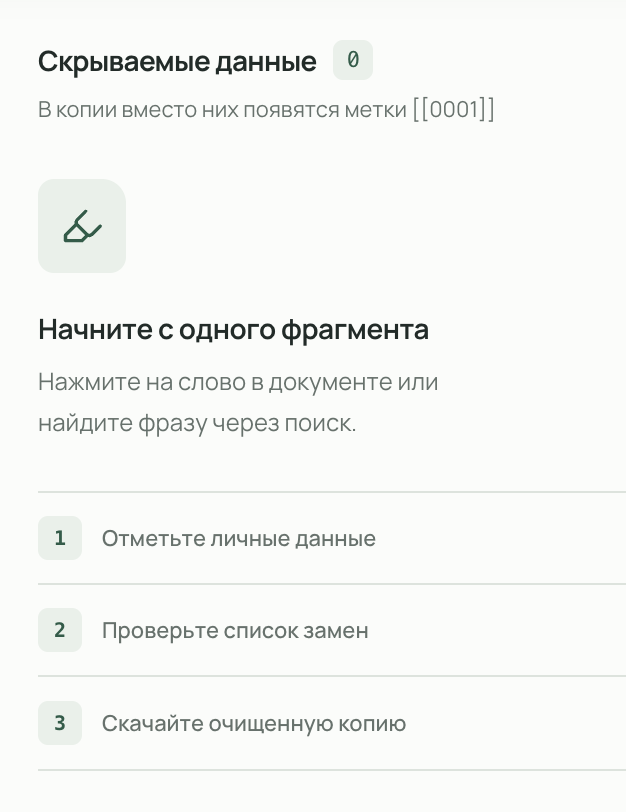
При генерации Doclear меняет подтверждённые фрагменты даже тогда, когда Word разбил их между несколькими элементами разметки. Вместе с этим он очищает поддерживаемые метаданные, комментарии и историю правок. Исходник не перезаписывается: получается отдельный DOCX. Перед выдачей сервис повторно открывает его и проверяет, что запрошенные действия действительно попали в собранный пакет.
Проверка не делает все части DOCX прозрачными. Изображения, вложения, активное содержимое и неизвестные элементы могут остаться в файле с предупреждением. В итоговом отчёте видно, что было обработано, а для некоторых непроверенных частей можно выбрать удаление и пересобрать документ. Скан страницы остаётся изображением: OCR в Doclear нет, поэтому искать в нём текст сервис не обещает.
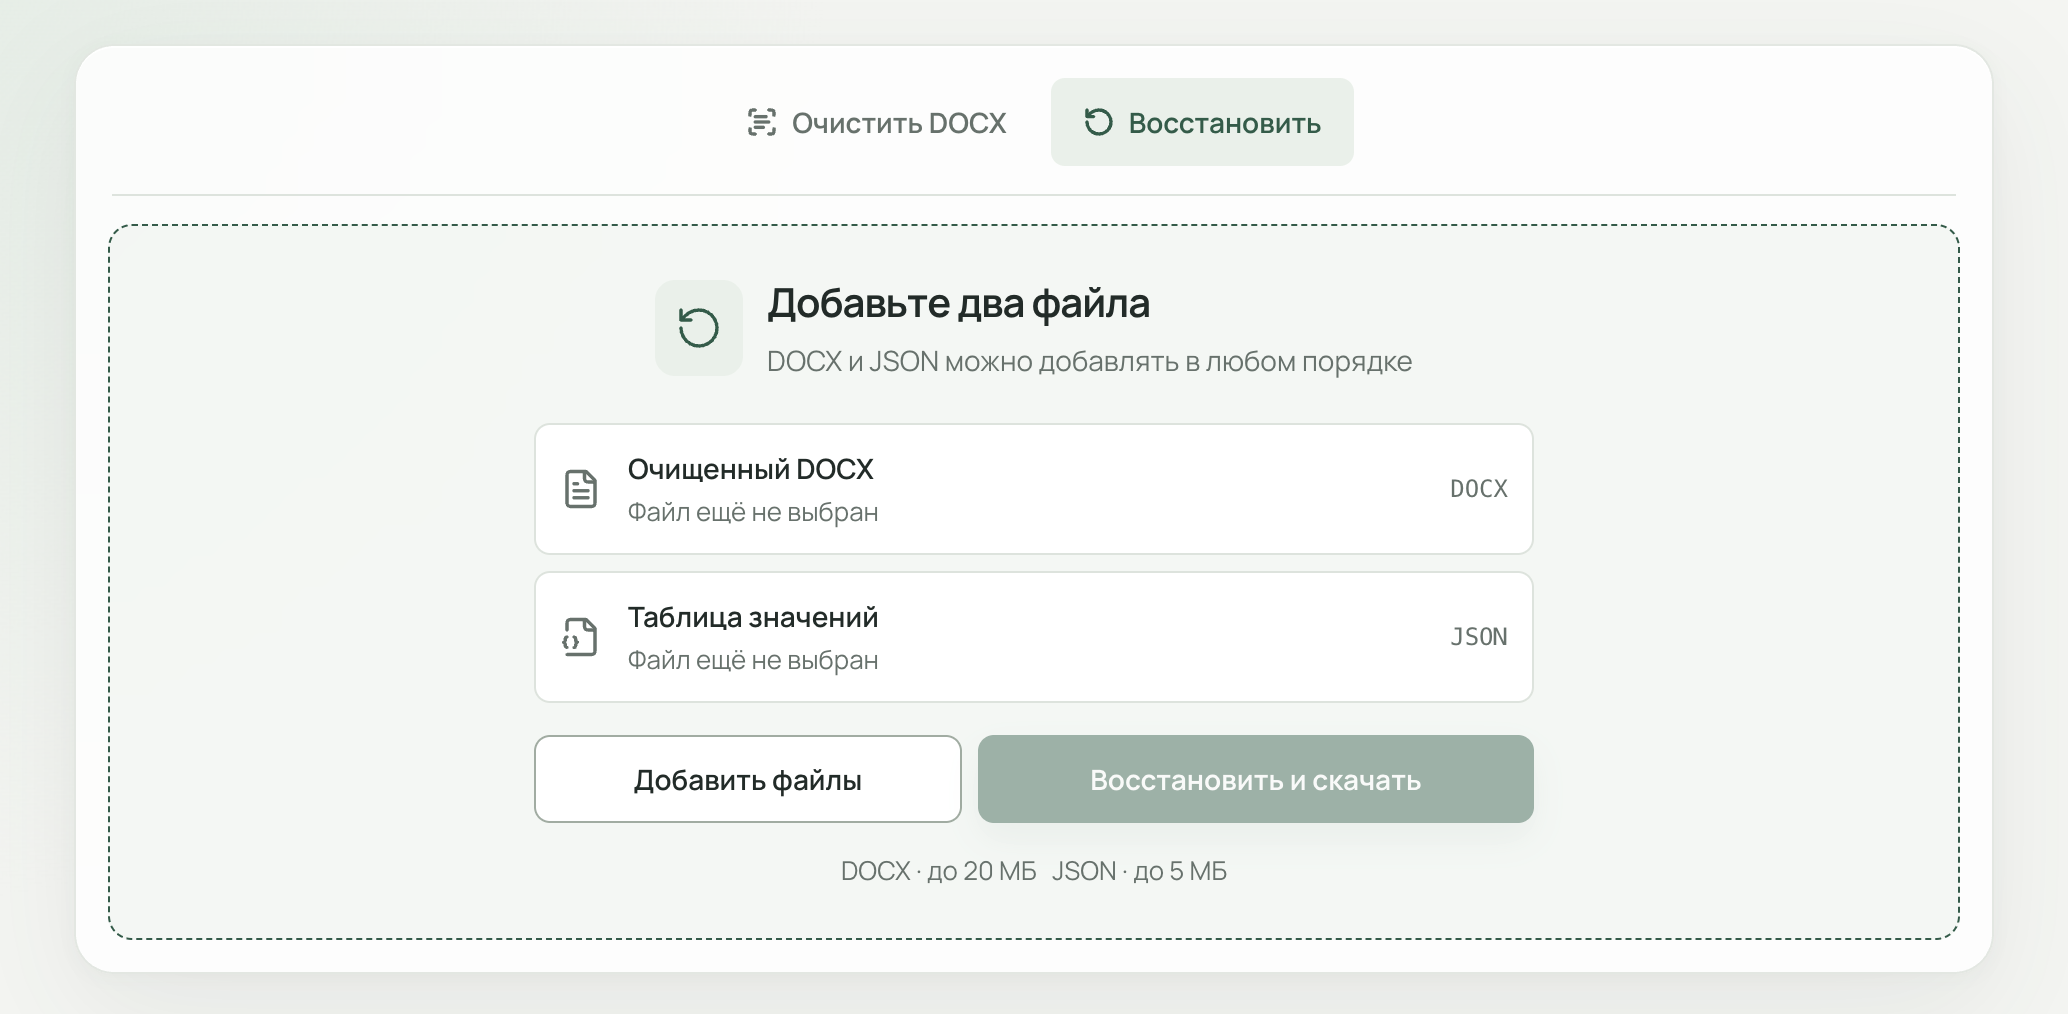
Для обратимой замены можно скачать JSON-таблицу соответствий плейсхолдеров и исходных значений. Это отдельный чувствительный файл: значения в нём записаны открыто, и хранить его рядом с очищенным DOCX было бы плохой идеей. Восстановление касается заменённого видимого текста; удалённые метаданные и комментарии обратно не появляются.
Пакетная обработка меняет границу данных
Ручной просмотр не подходит для пачки однотипных документов. В режиме «Авто» можно выбрать несколько DOCX или ZIP и категории данных, которые нужно искать. Отдельно выбранные файлы браузер упаковывает в технический архив и отправляет на сервер после явного выбора этого режима. Сервер проверяет архив, ставит документы в последовательную очередь и передаёт текст внутреннему сервису моделей.
Серверный режим возвращает в интерфейс ход обработки, имена файлов и общие счётчики, без текста находок. Результаты можно скачать по отдельности или одним ZIP; исходные файлы при этом не изменяются. Задание и готовые копии хранятся в памяти процесса ограниченное время. Это сокращает повторяющиеся действия, но требует передать документы серверу и принять решения моделей без просмотра каждой замены.
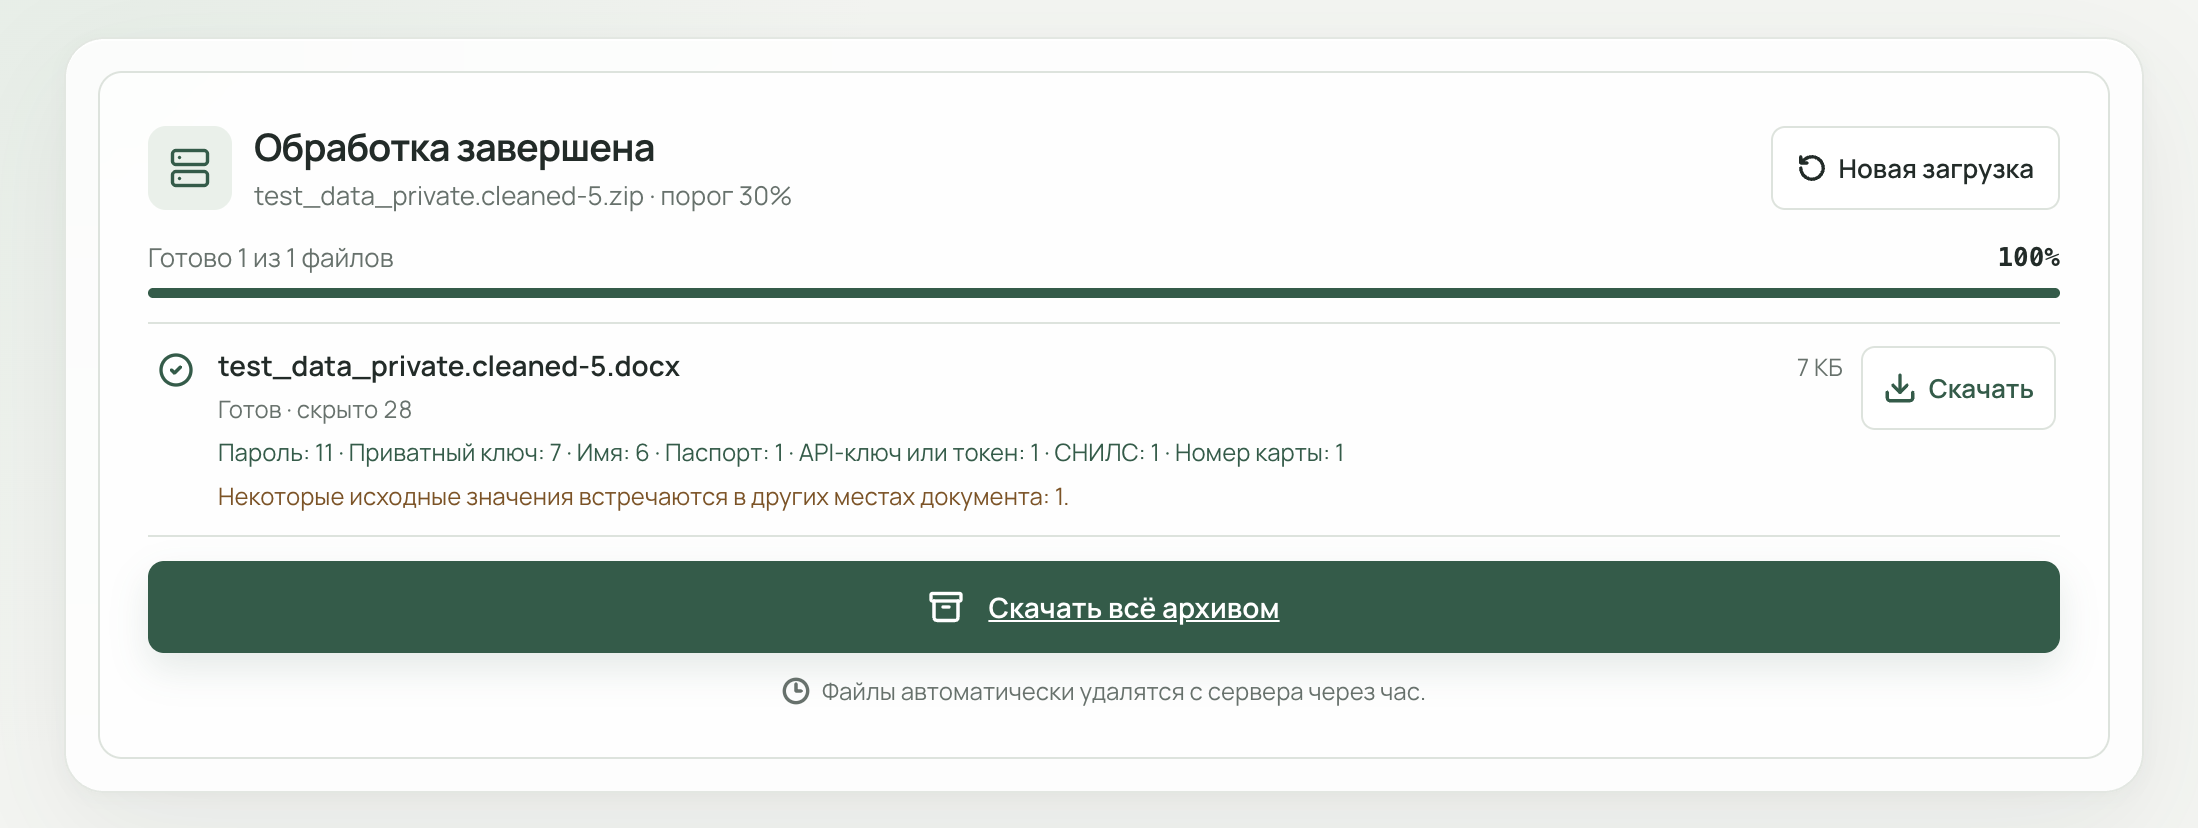
Ни один из режимов не гарантирует, что чувствительные данные найдены полностью. Модели могут пропустить значение или выделить лишнее, а DOCX может содержать непроверенные части. Поэтому после обработки важно открыть новый файл и прочитать отчёт, особенно если его собираются отправить за пределы команды.
Ниже упрощённый пример на вымышленных данных. Кнопка показывает сам принцип замены отмеченных фрагментов; настоящий Doclear дополнительно разбирает пакет, пересобирает DOCX и проверяет полученный файл.
Заказчик: Иванов Иван Иванович
Почта: ivanov@example.ru
Телефон: +7 999 123-45-67
Стороны согласовали условия выполнения работ и порядок обмена документами.
Я вынес выбор режима перед загрузкой: человек заранее видит, останется ли DOCX в браузере или уйдёт в серверную очередь. После обработки отчёт и новая копия возвращают ему контроль над следующим шагом — открыть файл и решить, готов ли он к отправке.
Технологии и устройство
React и TypeScript показывают документ; Web Worker разбирает OOXML и собирает новый DOCX, серверная очередь обрабатывает пакетные задания.
- Интерфейс
- React, TypeScript и Vite. Просмотр находок и ручная замена работают в браузере.
- Локальная обработка
- Web Worker разбирает и пересобирает DOCX с помощью JSZip и XML-инструментов. Дополнительный поиск может запускать ONNX-модели в браузере.
- Пакетный режим
- Node.js принимает ZIP, выбранный пользователем или собранный браузером из нескольких DOCX. Отдельный внутренний сервис запускает модели; интерфейс получает статусы и счётчики без текста находок.
- Граница данных
- В режиме «Эксперт» файл не отправляется в API обработки документов. Пакетная обработка использует серверную очередь и временные результаты в памяти процесса.