
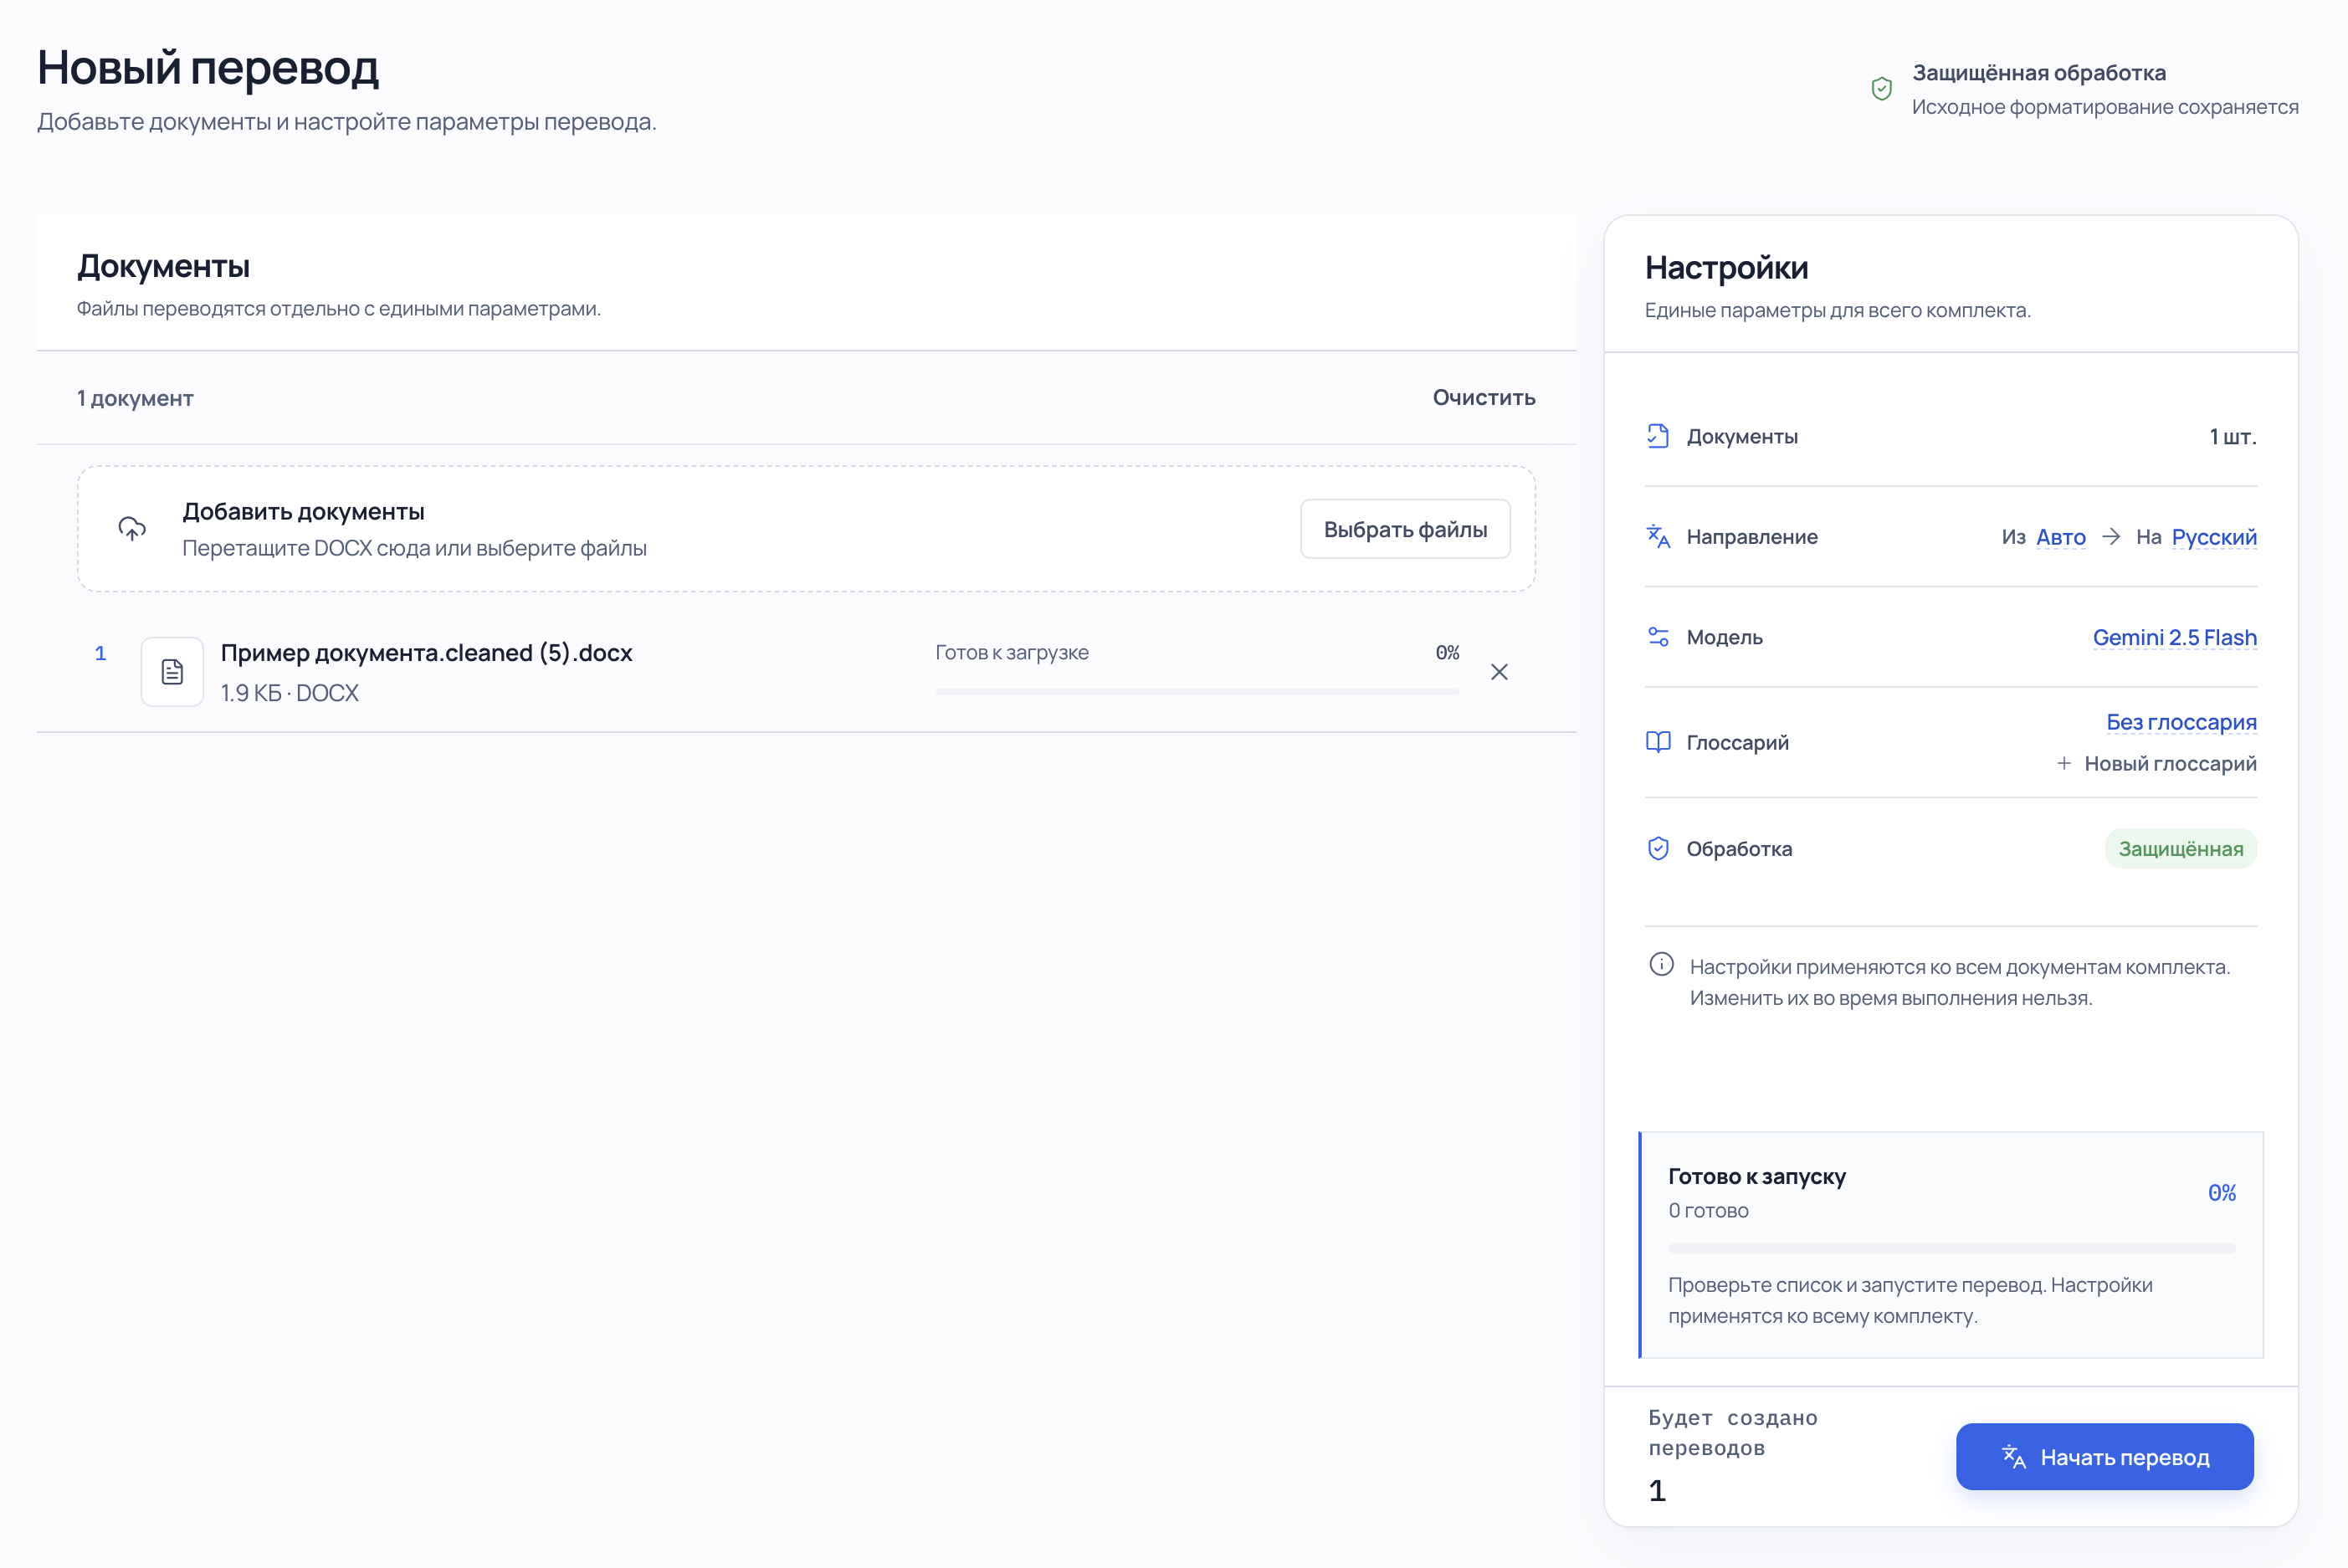
В интерфейсе Langword можно выбрать несколько DOCX и один раз задать параметры перевода. Для сервера такой комплект не должен быть неделимой работой: файл с неподдерживаемым содержимым нужно отклонить, не задерживая обработку остальных. Готовый результат одного документа тоже не должен ждать завершения всего набора.
Я оставил комплект на уровне интерфейса. Пользователь выбирает языки, модель и глоссарий, а React-клиент создаёт отдельную задачу перевода для каждого загруженного документа с одинаковыми настройками. На сервере у каждой задачи собственный статус, попытка обработки и результат. Поэтому частичный успех остаётся видимым: уже созданные задачи не пропадают, если запрос для одного из файлов завершился ошибкой.
Очистка до загрузки
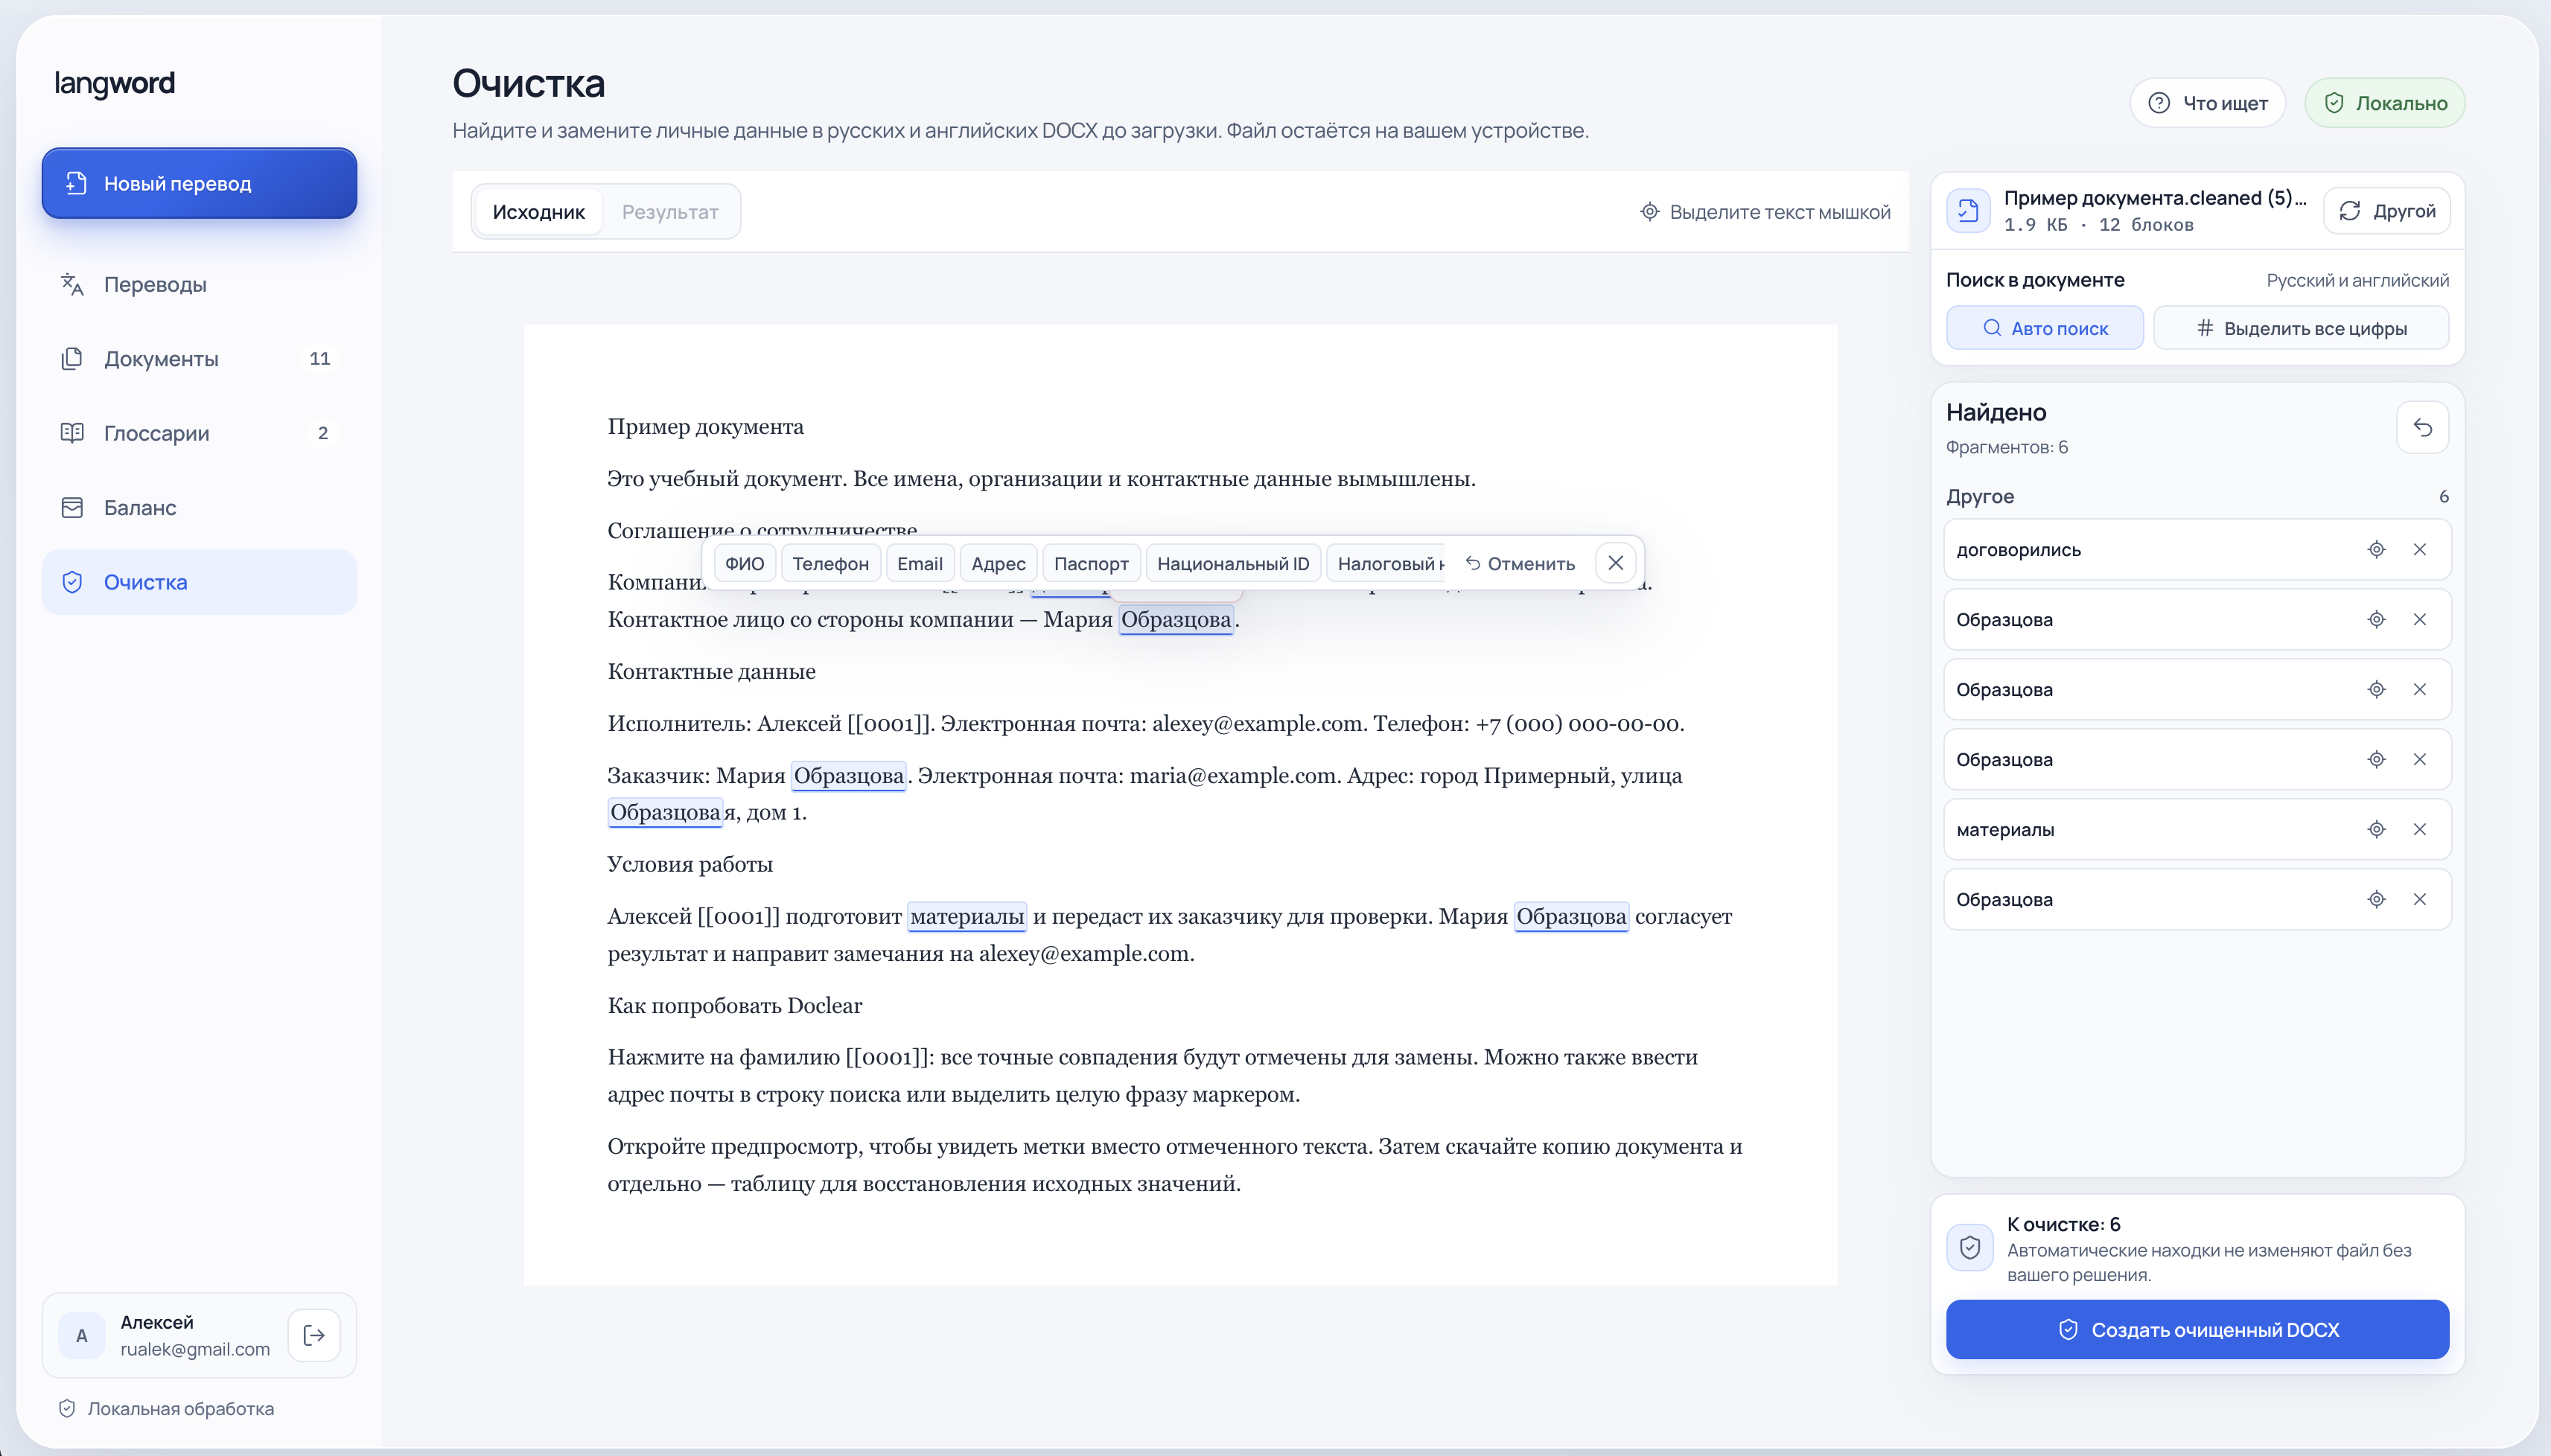
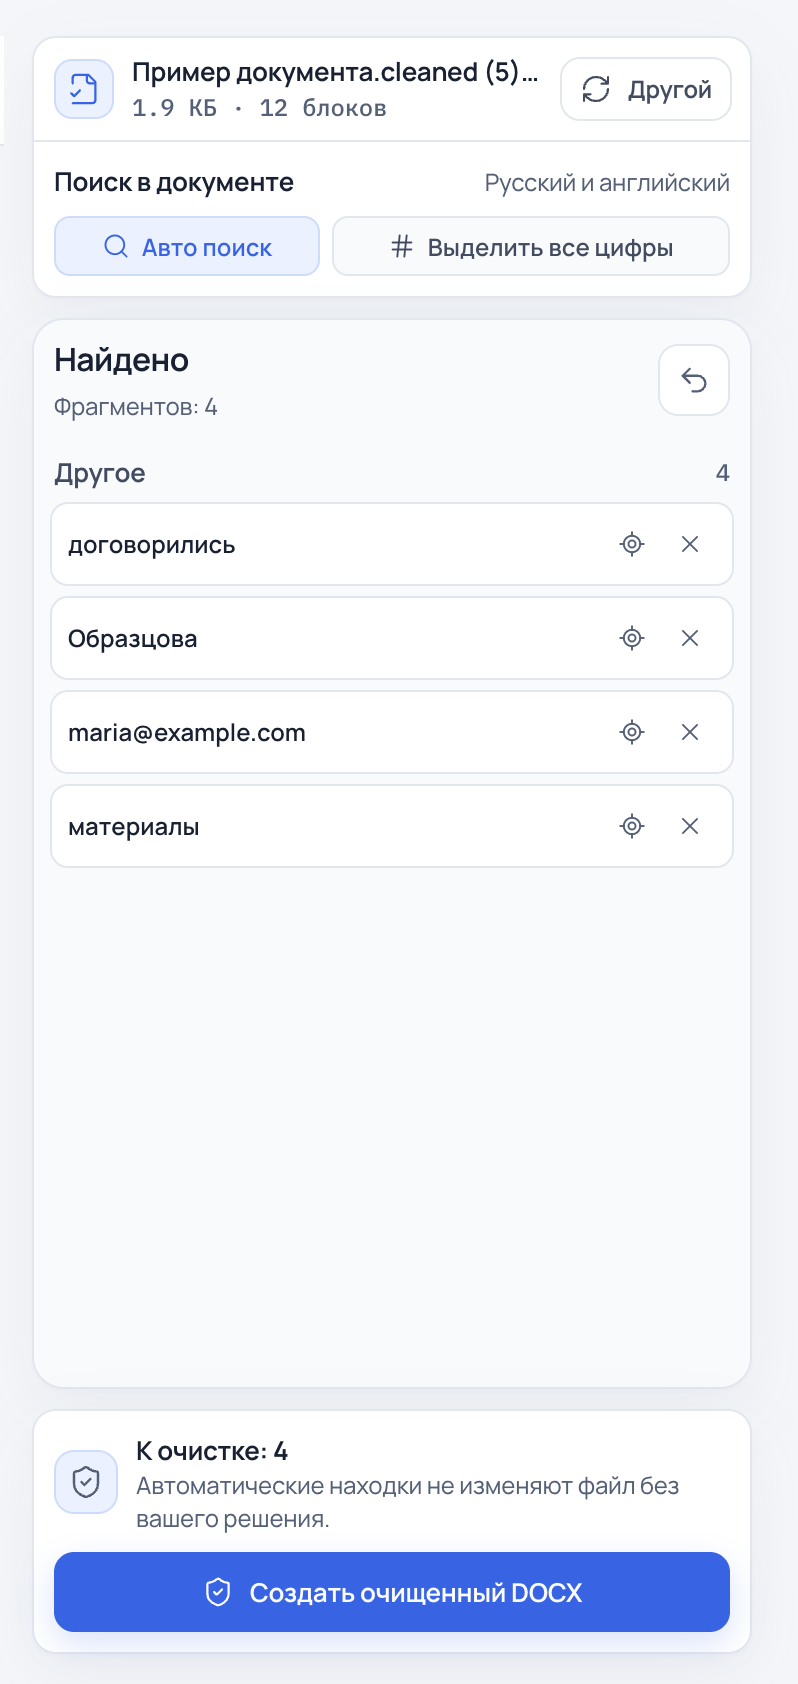
Если в исходнике есть личные данные, его можно сначала открыть в разделе очистки. Этот экран работает с DOCX локально: показывает найденные фрагменты прямо в документе и позволяет решить, какие из них заменять. Автоматический поиск сам по себе не меняет файл; очищенная копия создаётся после выбора пользователя.
Сначала подтвердить файл
Загрузка отделена от перевода. Браузер читает DOCX, считает контрольную сумму и получает у API подписанные поля для отправки файла напрямую в S3-совместимое хранилище. FastAPI не принимает бинарный файл в запросе на создание задачи. После загрузки отдельное подтверждение сверяет размер и контрольную сумму, проверяет ZIP и структуру OOXML и только затем переводит документ из временной области в хранилище проверенных исходников.
Проверка файла до постановки в очередь нужна не только для сообщения об ошибке. DOCX — это архив со связанными XML-частями: расширение имени ещё не говорит, что его можно безопасно открыть и восстановить после перевода. Если в документе есть макросы или нарушена структура пакета, задачу лучше не создавать. PDF и сканы этот путь не принимает: здесь нужен редактируемый DOCX.
Стоимость видна перед запуском
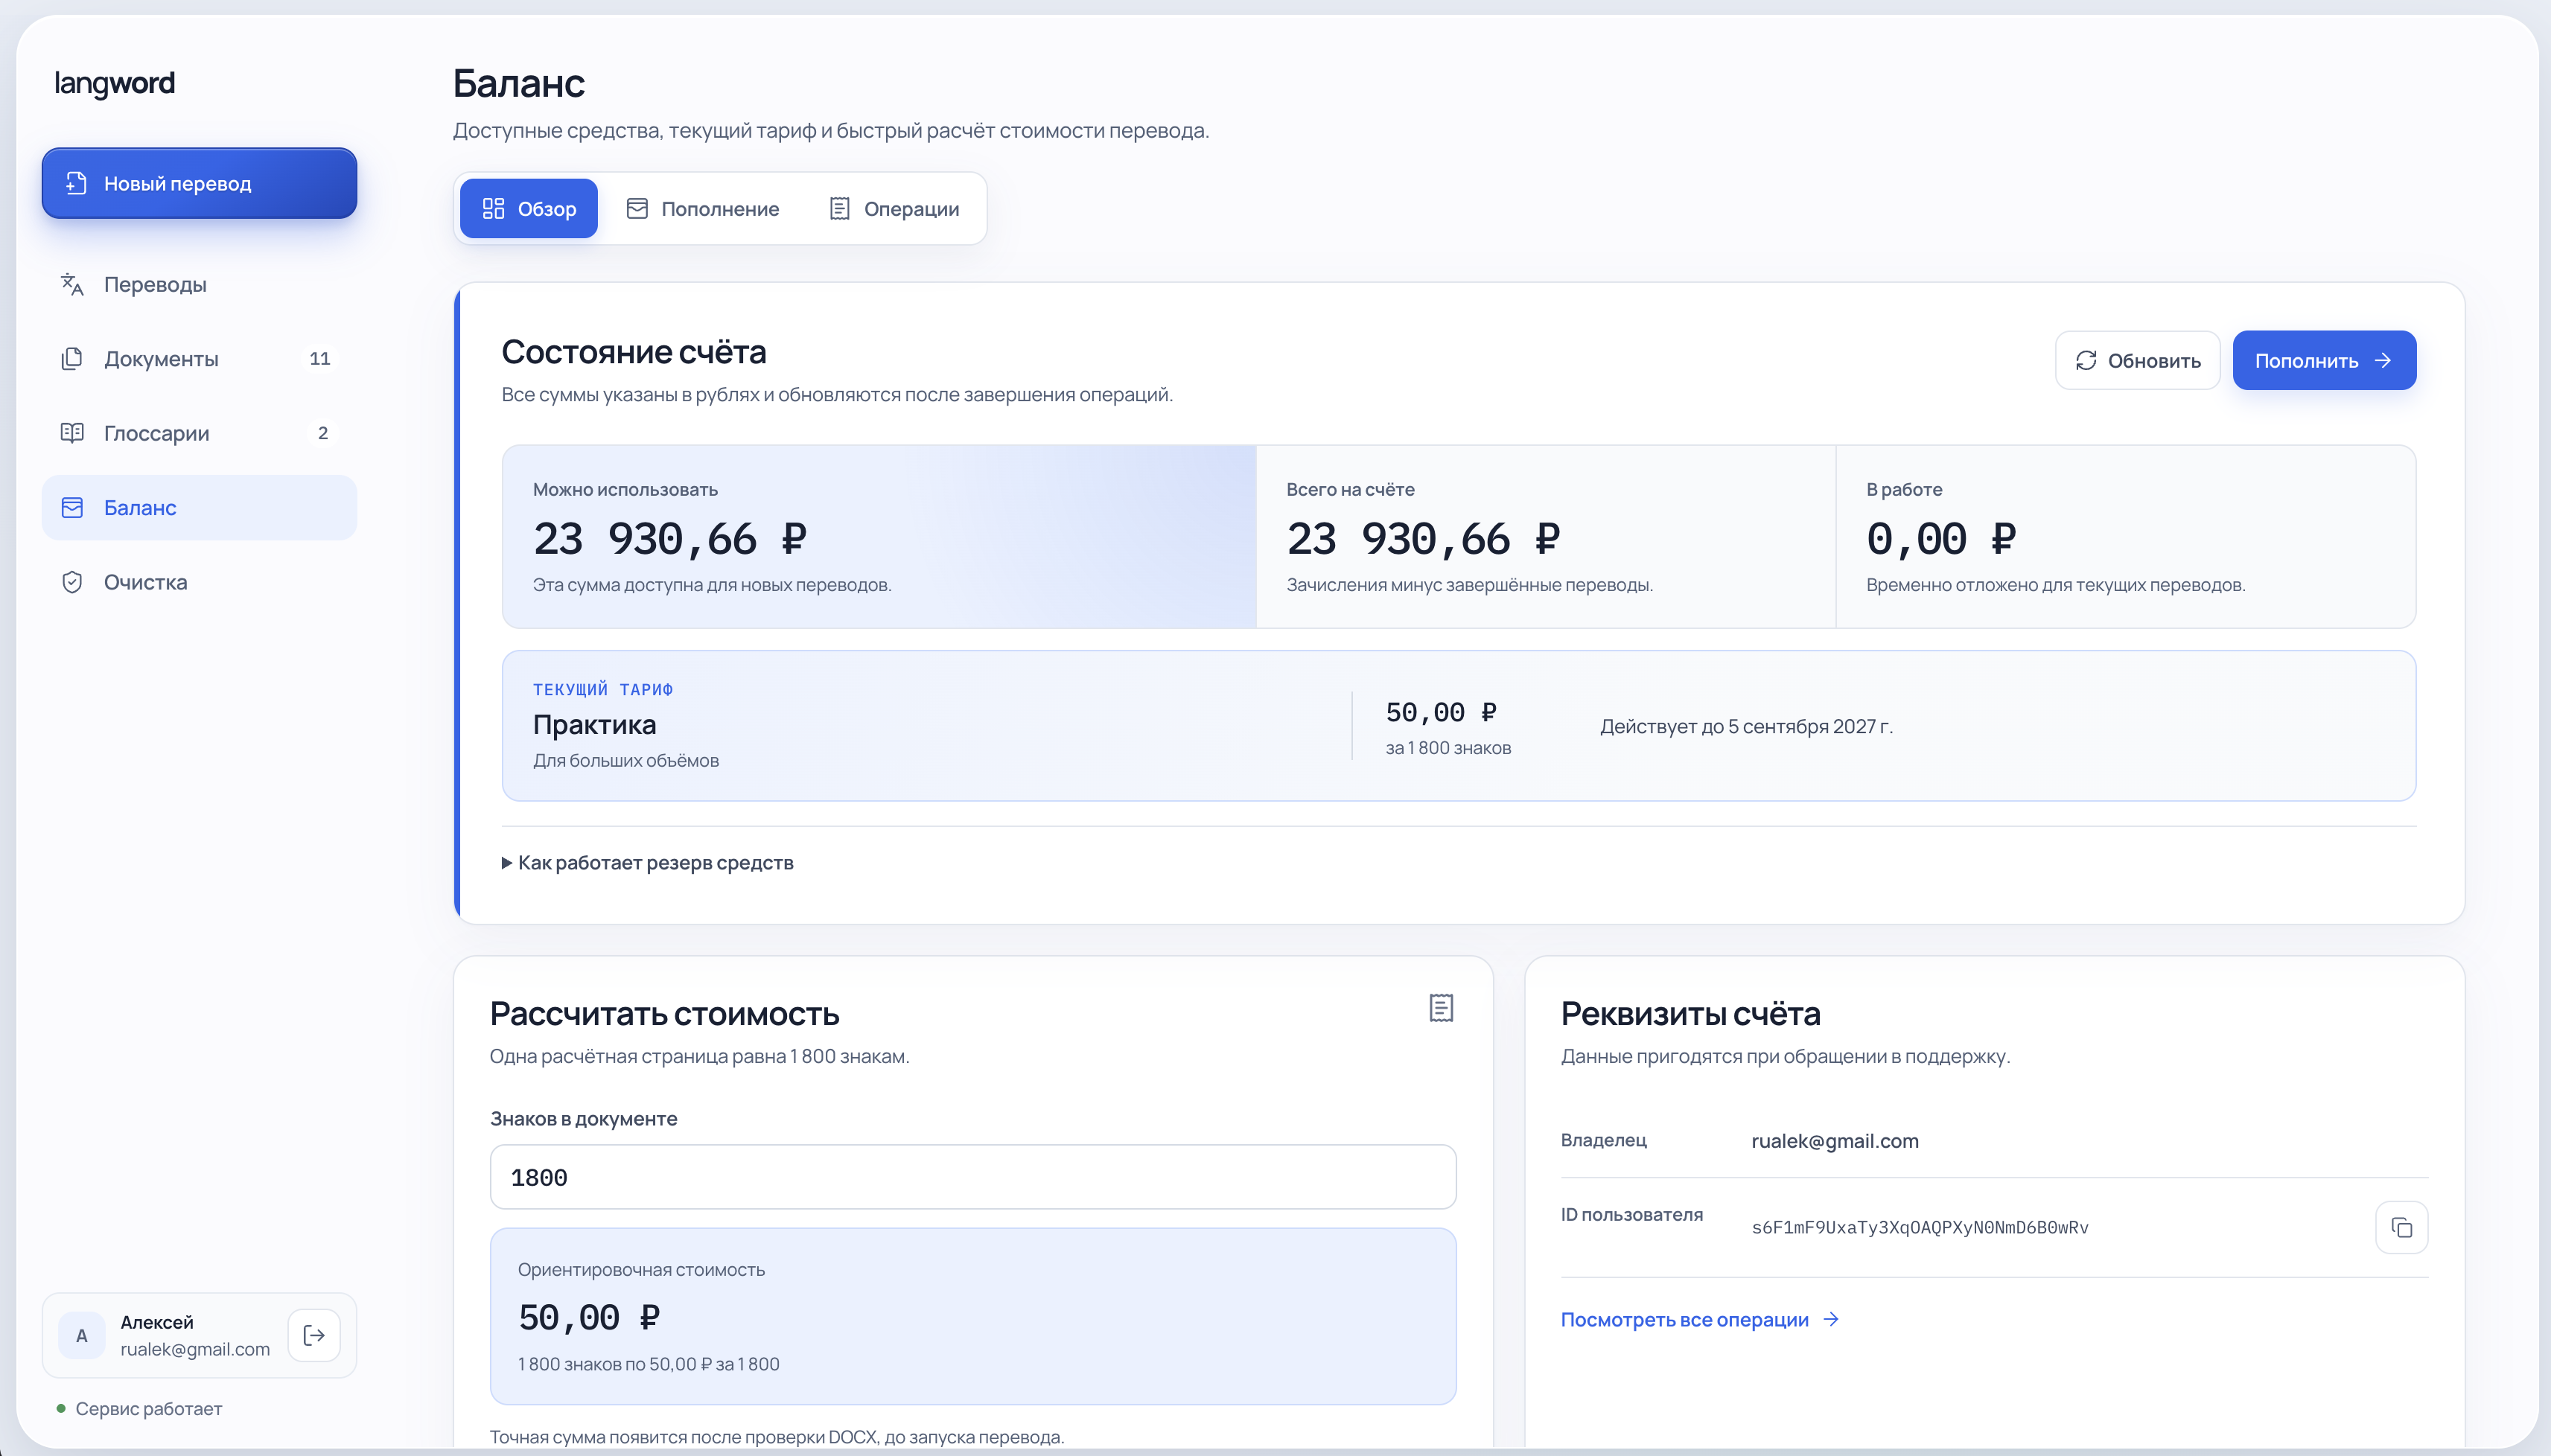
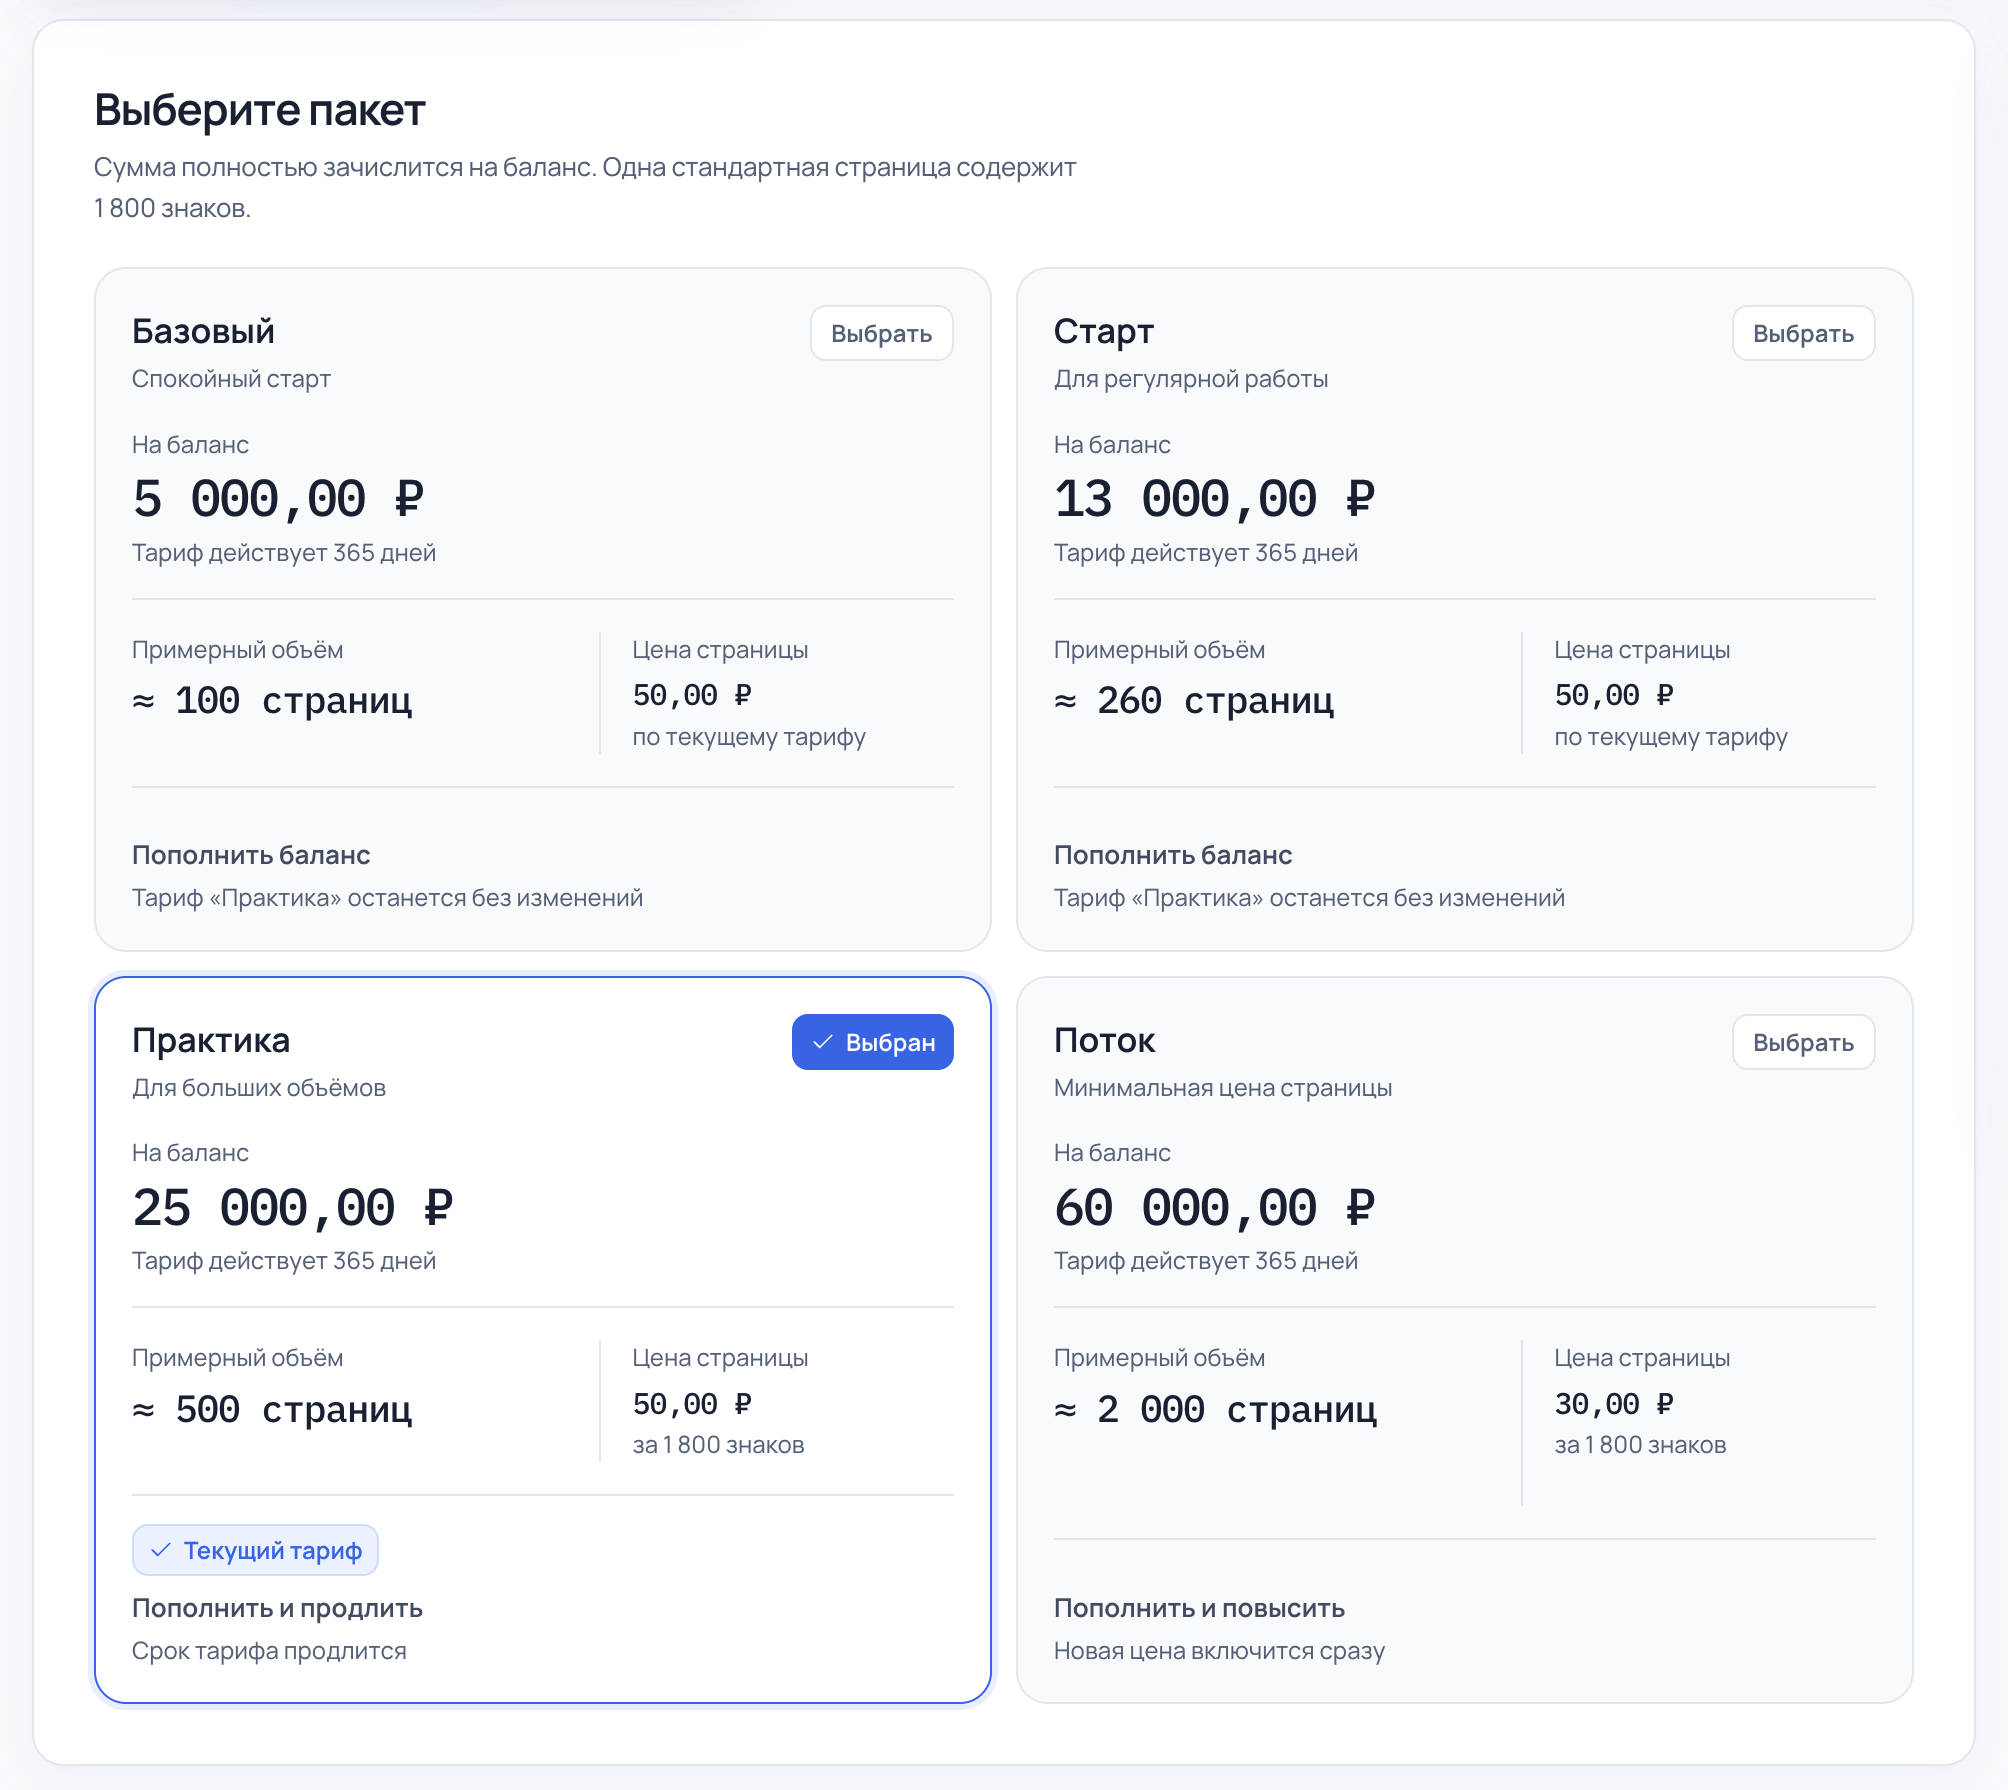
На экране баланса видно, сколько средств доступно для новых переводов и сколько зарезервировано под текущие задачи. Калькулятор даёт предварительную оценку по объёму документа; отдельный экран показывает пакеты пополнения и условия тарифа. Так стоимость можно проверить до отправки DOCX в очередь.
Очередь не должна быть источником истины
Состояние задач, прогресс и выбранные настройки хранятся в PostgreSQL. Отдельный планировщик допускает работу в пределах лимитов, сохраняет резервирование и событие для отправки в одной транзакции. Затем dispatcher публикует событие в RabbitMQ, а Celery worker перечитывает актуальную задачу из базы. Повторная доставка сообщения возможна, поэтому обработчик проверяет состояние и не создаёт второй результат только из-за повтора.
Для долгих переводов я добавил режим исполнения по частям. Когда он включён в конфигурации, новые задачи сохраняют проверенные результаты частей в закрытом объектном хранилище, а их состояние — в PostgreSQL; после перезапуска worker может продолжить незавершённую работу. Это не даёт обещания, что внешний вызов модели никогда не повторится: сбой между ответом модели и записью результата оставляет такую возможность. Зато уже сохранённые части не приходится переводить заново только потому, что процесс остановился позже.
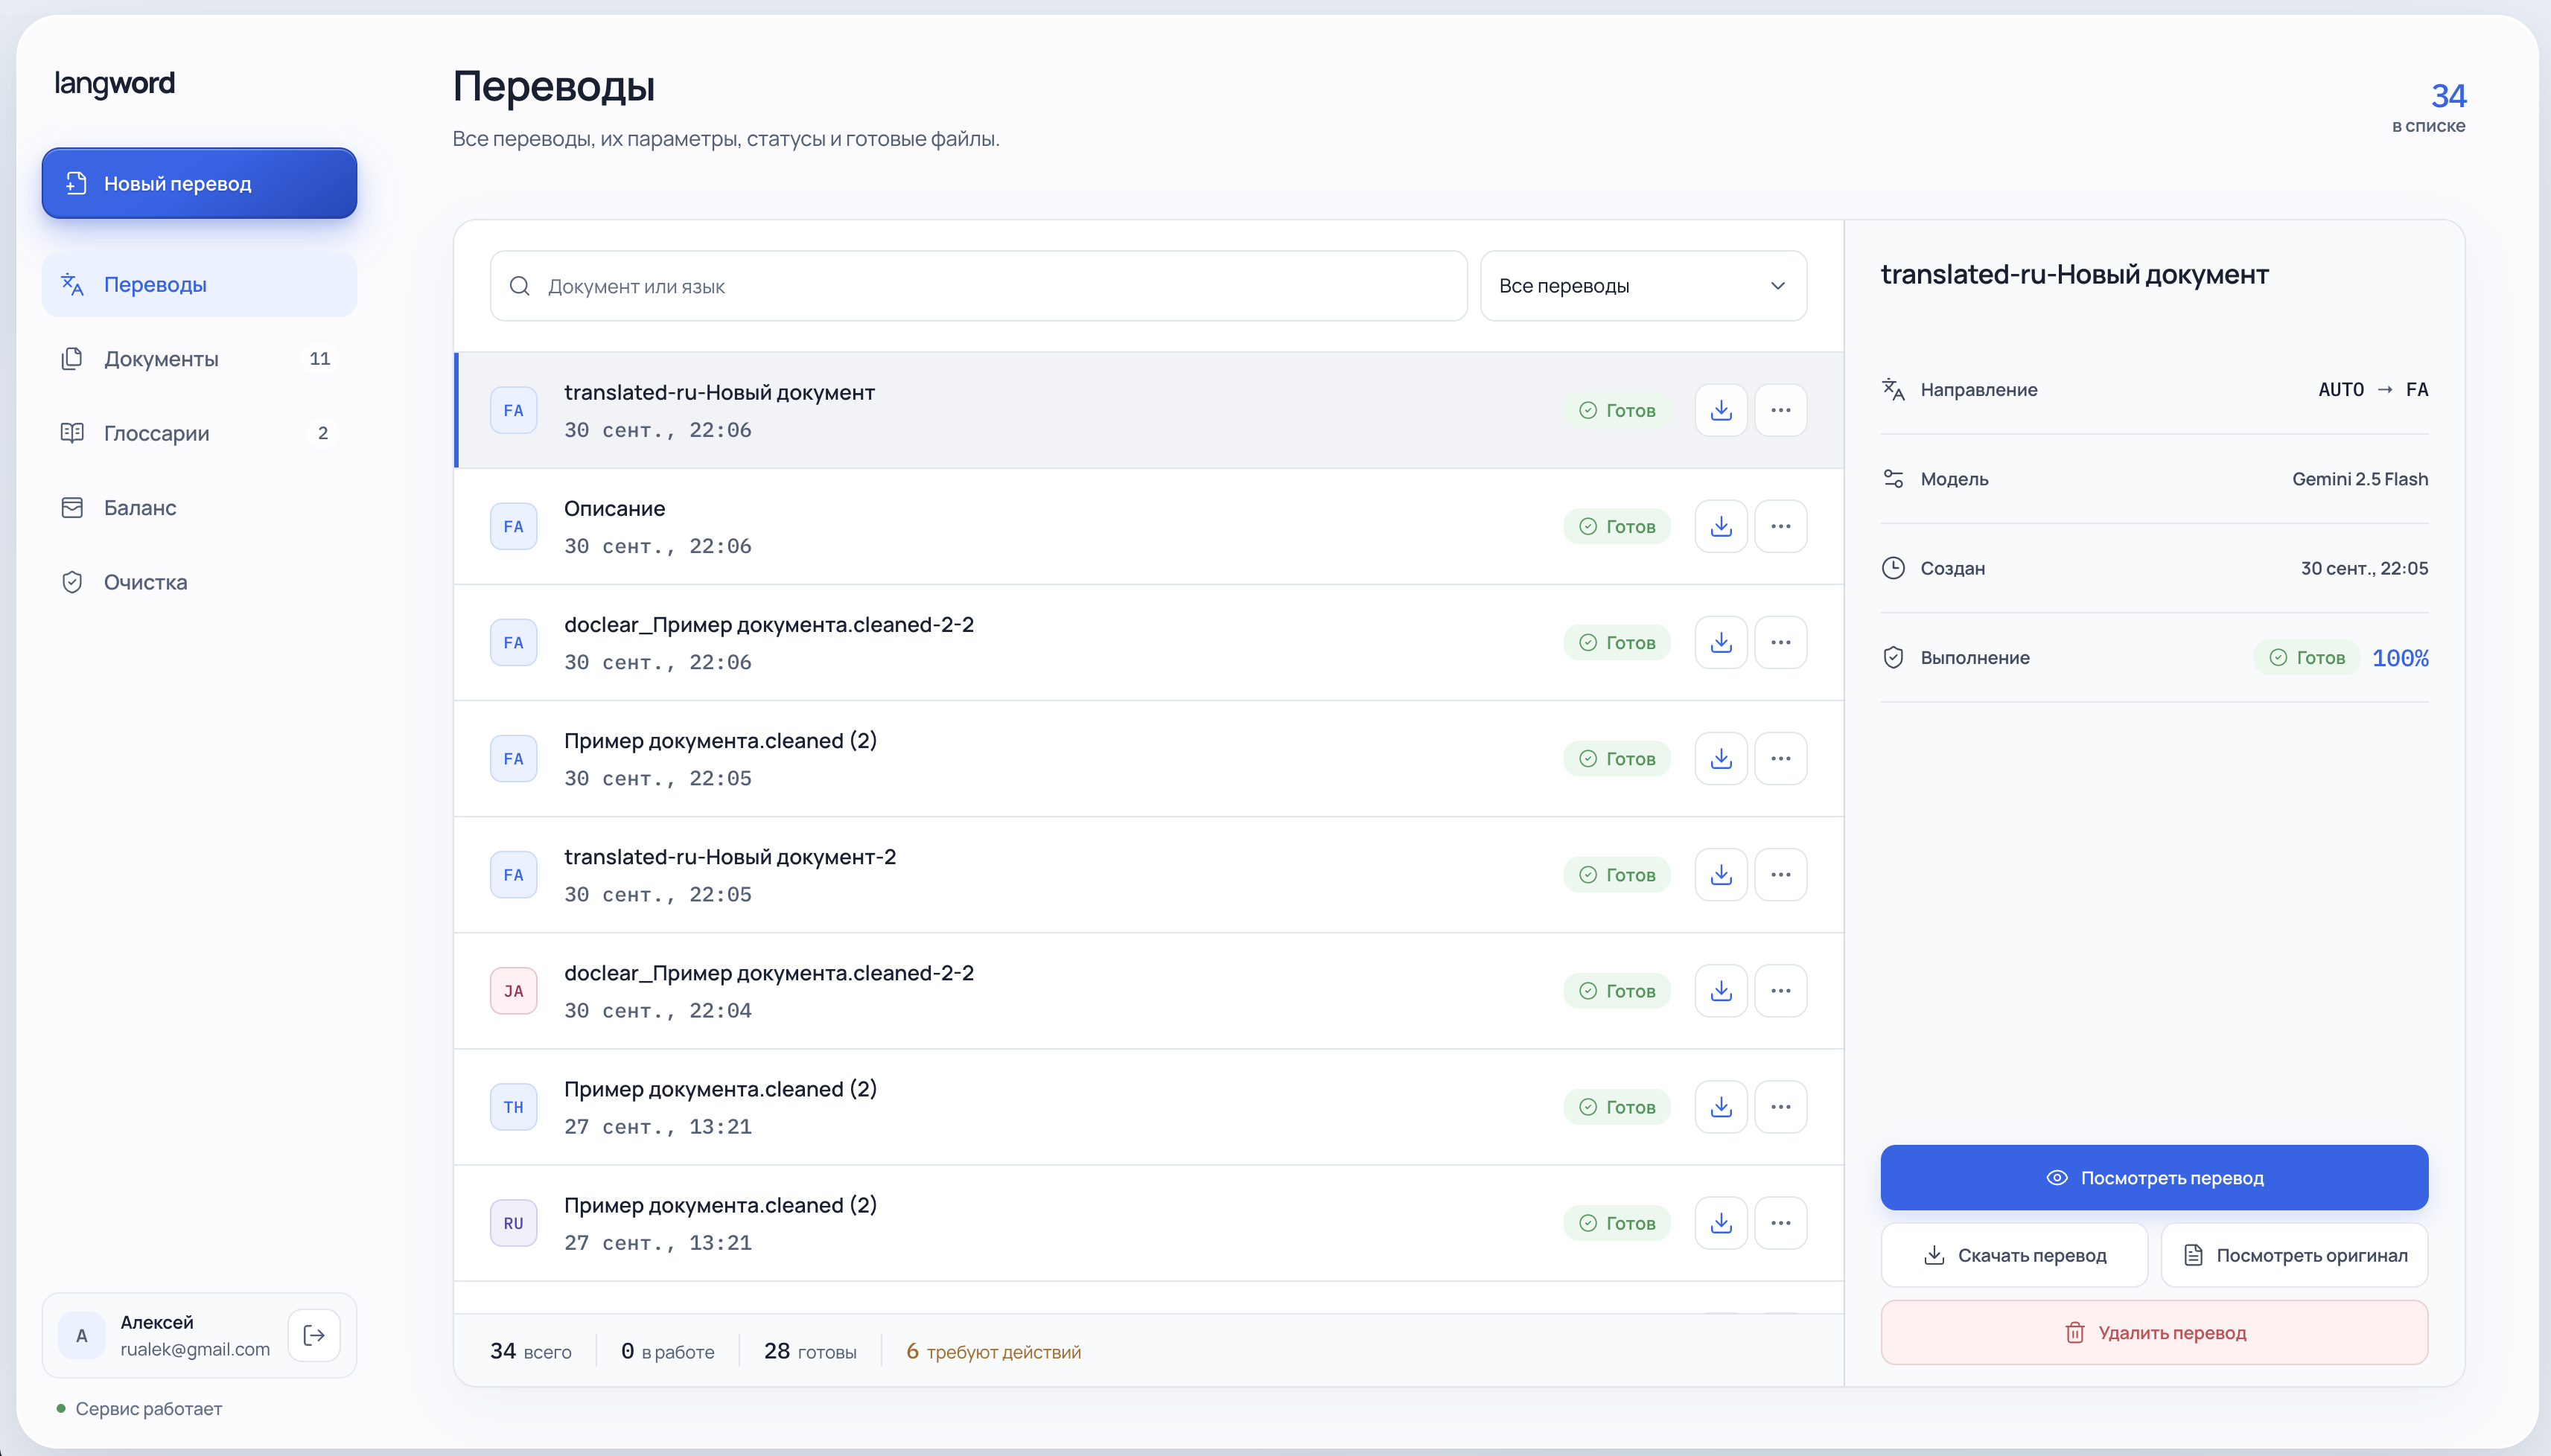
Клиент опрашивает API о ходе каждой задачи и показывает её отдельно от других файлов. Отмена тоже относится к конкретному переводу: для активной работы сервер фиксирует запрос, а worker останавливается на ближайшей безопасной границе, завершив уже начатый вызов модели. Интерфейс не изображает мгновенную остановку там, где её нет.
Заменить текст и сохранить DOCX
Для модели документ нельзя просто превратить в одну строку. Worker извлекает переводимые фрагменты из основной части, таблиц, колонтитулов и ссылок, а для каждого сохраняет место в OOXML и идентификатор, связанный с конкретным исходным файлом. Повторяющиеся фразы в разных местах получают разные идентификаторы. URL и технические маркеры защищаются плейсхолдерами, которые результат перевода обязан вернуть.
После ответов модели worker проверяет, что получен ровно один перевод для каждого ожидаемого фрагмента, возвращает защищённые значения и меняет только целевые текстовые узлы. Затем он заново открывает DOCX и сверяет структуру пакета, связи, изображения и форматирование. Известные сложные конструкции, для которых этот путь не проверен, отклоняются. Текст в комментариях, сносках и текстовых полях сохраняется как часть файла, но не отправляется на перевод; это важно помнить при просмотре результата.
Термины нужно закреплять вместе с настройками
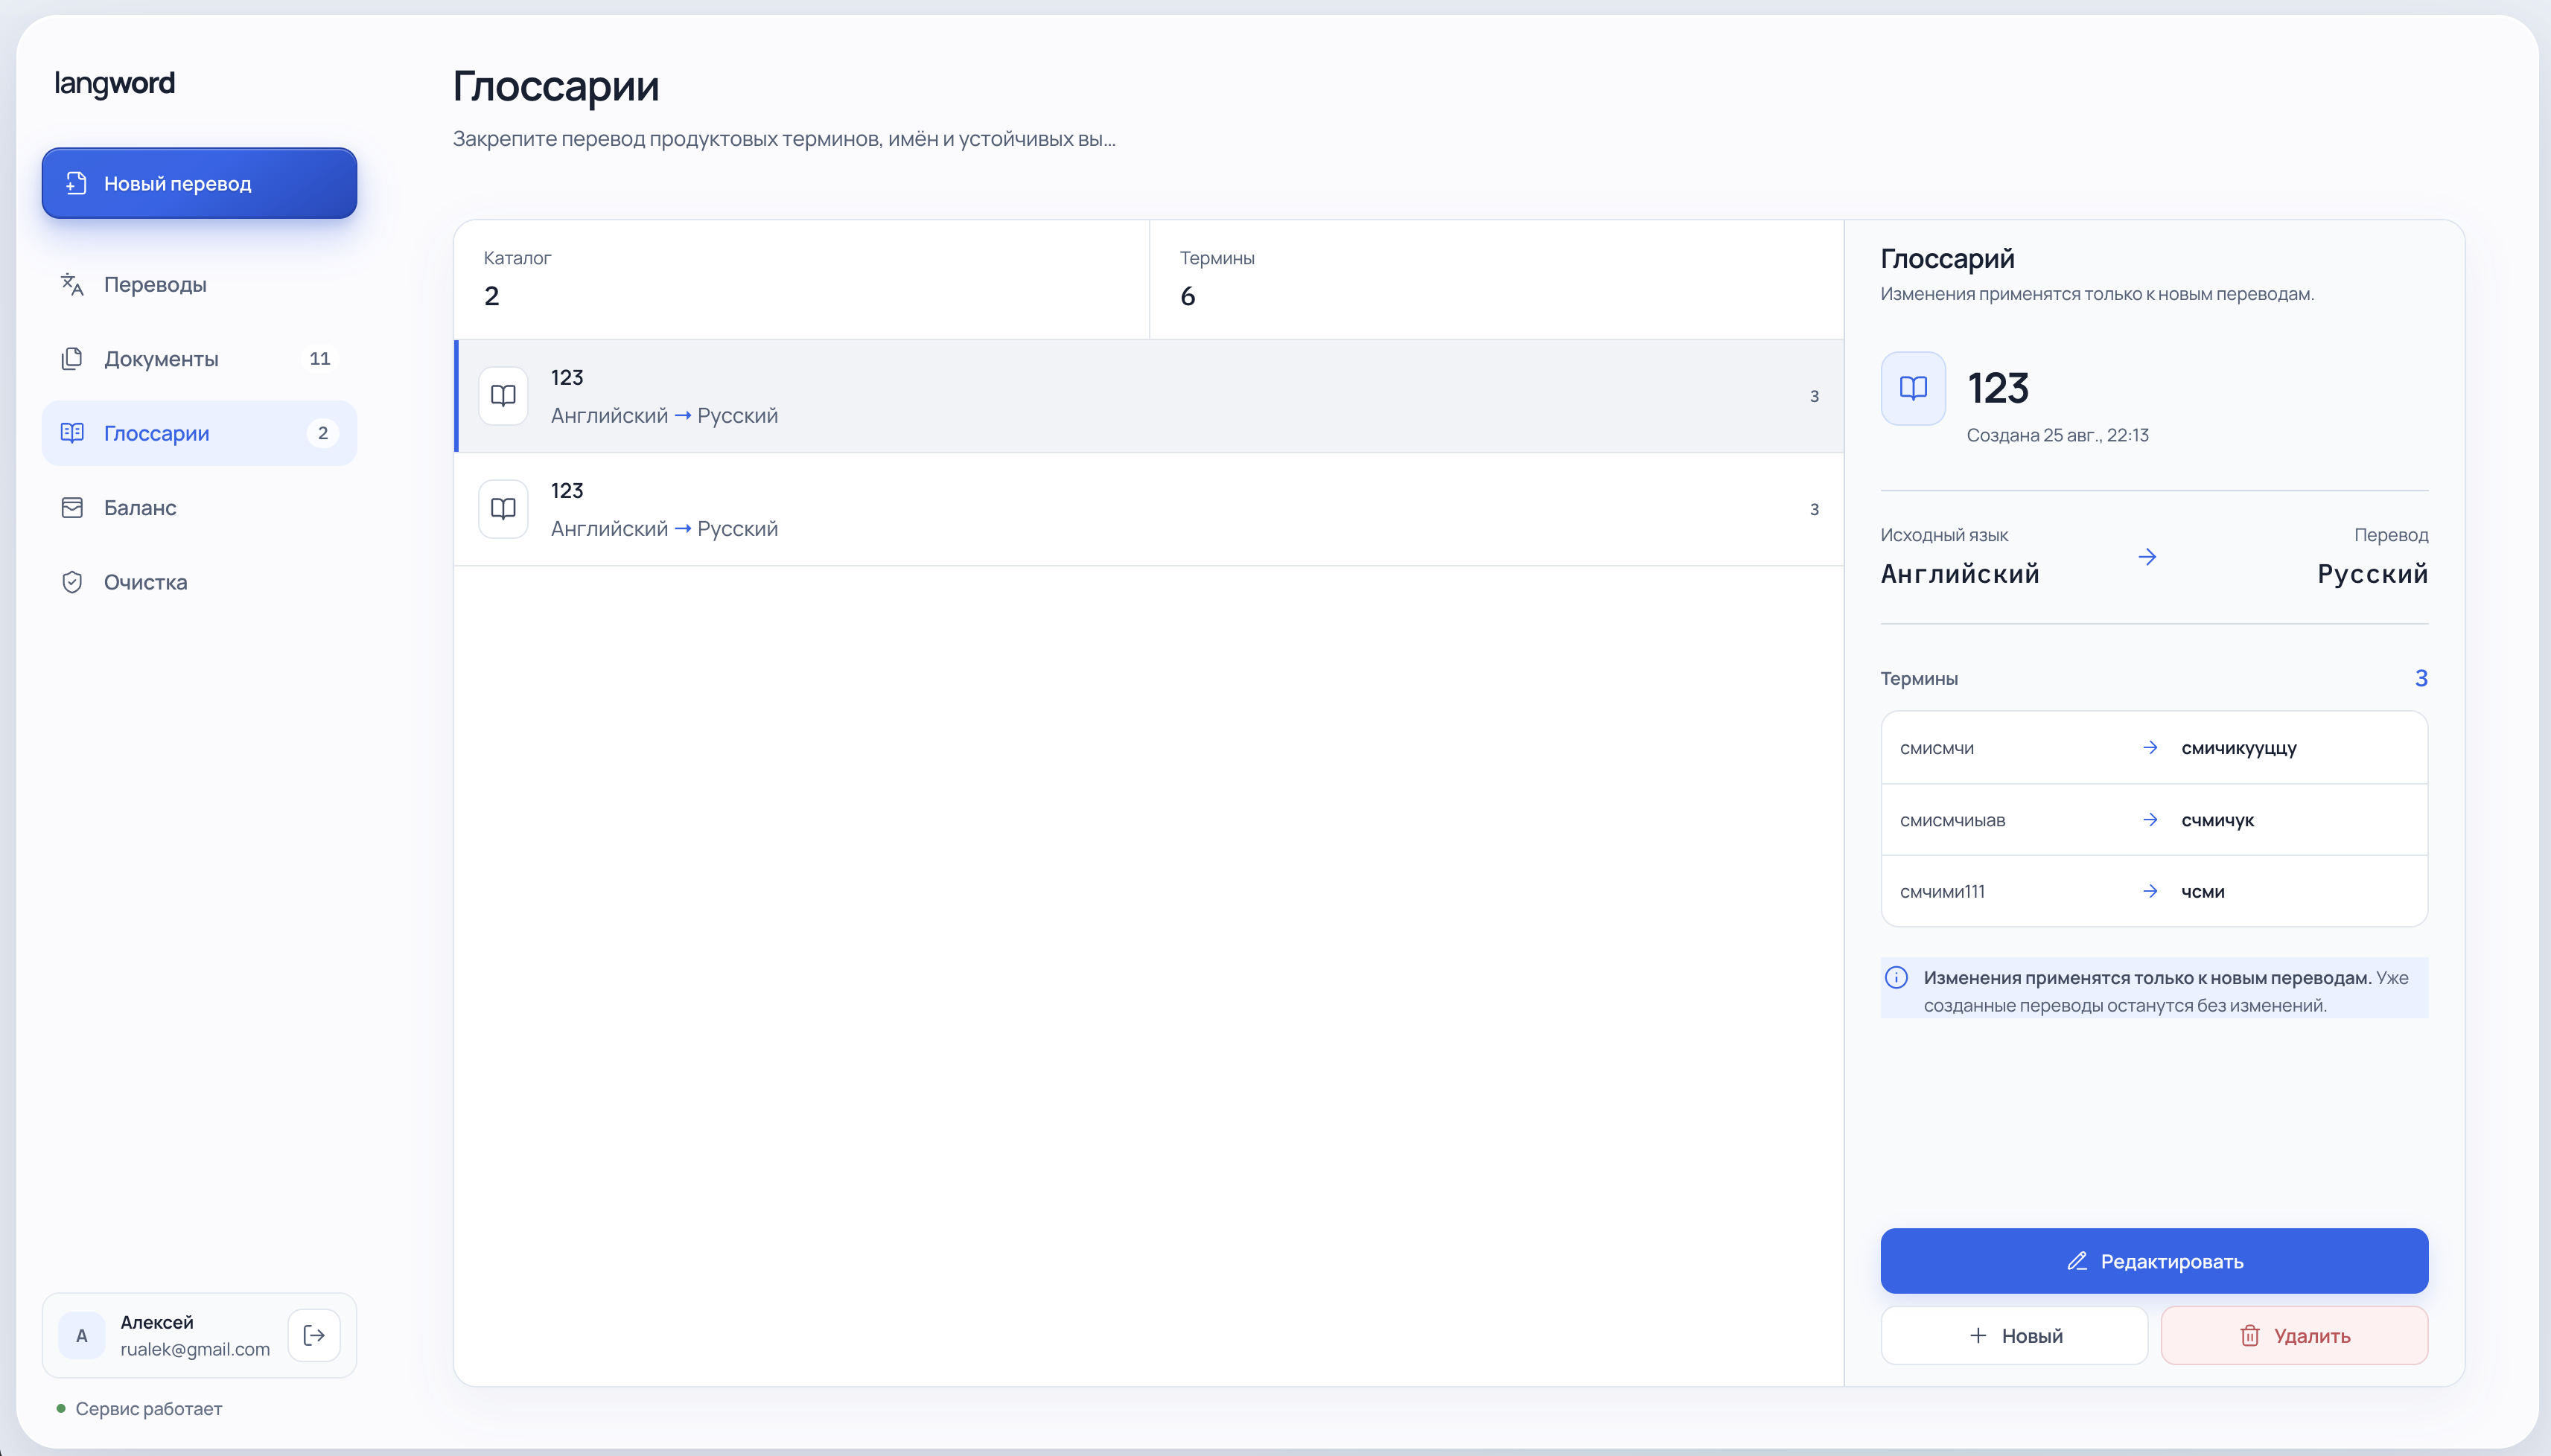
Глоссарий может измениться, пока задача ждёт своей очереди. Поэтому его правка создаёт новую неизменяемую ревизию, а задача получает идентификатор конкретной версии. Перед первым вызовом модели worker сохраняет её снимок. Если позже исправить термин, уже созданный перевод останется связан с прежним набором правил, а новая задача сможет использовать новую ревизию. Так результат не зависит от того, в какой момент очередь дошла до файла.
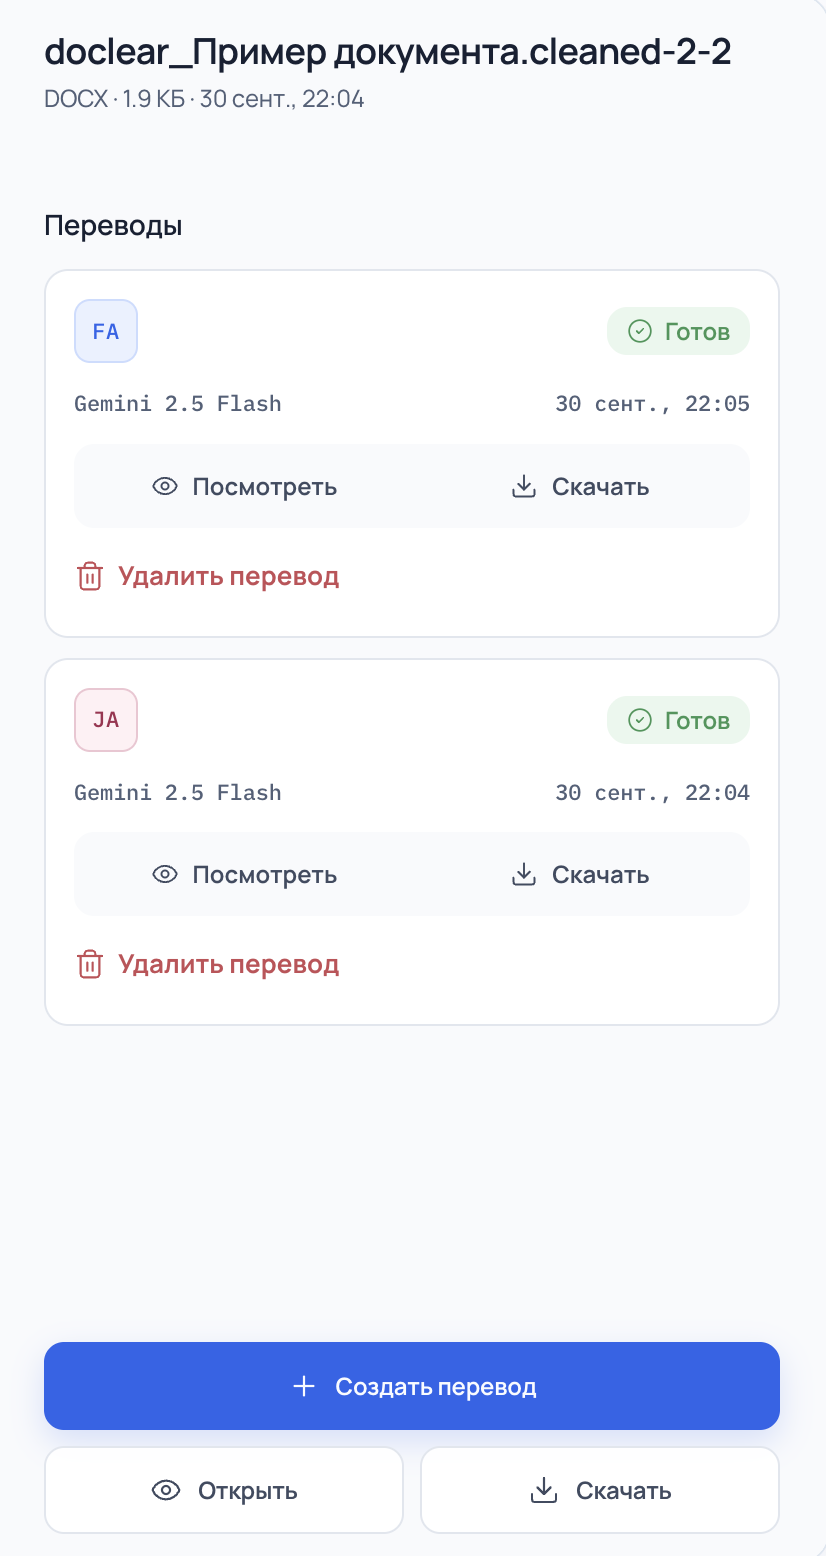
Готовый перевод открывается в браузере через docx-preview и скачивается отдельным DOCX; исходник остаётся доступен отдельно. У одного документа могут быть разные переводы, и каждый остаётся отдельным результатом.
Структурная проверка доказывает, что файл собран по поддерживаемым правилам, но не оценивает смысл формулировок. Поэтому после завершения задачи остаётся человеческая работа: сопоставить термины и важные места с исходником, особенно там, где документ будут использовать как рабочий или юридический текст.
Технологии и устройство
React и TypeScript управляют отдельными переводами; FastAPI, PostgreSQL и Celery проводят каждый DOCX через проверку, очередь и сборку результата.
- Интерфейс
- React, TypeScript и Vite. Для каждого документа создаётся отдельная задача; прогресс приходит через polling, DOCX открывает docx-preview.
- Загрузка и API
- Браузер отправляет файл по подписанному multipart POST в MinIO или S3. FastAPI подтверждает контрольную сумму и структуру DOCX перед созданием задачи.
- Очередь
- PostgreSQL хранит состояние задач; планировщик и transactional outbox передают работу через RabbitMQ в Celery. В режиме исполнения по частям готовые результаты переживают перезапуск worker.
- DOCX и модель
- Python worker извлекает адресные OOXML-фрагменты, отправляет их через LLM Gateway и проверяет структуру собранного DOCX перед выдачей результата.
- Глоссарии
- Правка создаёт новую неизменяемую ревизию. Задача закрепляет её идентификатор, а worker сохраняет снимок терминов до вызова модели.