
В демонстрации Interactive Visualization of Telegram выбранный канал стоит в центре графа. Зелёная стрелка показывает, что он переслал чужой пост. Оранжевая ведёт в обратную сторону: публикацию выбранного канала забрали к себе другие. Толщина связи зависит от числа пересылок. Уже по этой схеме видно то, что трудно заметить в обычной ленте: кто регулярно разносит чужие сообщения, а кто становится их источником.
Интерфейс разработали Чон Ын Чхве, Карла Шефер и Мартин Штайнебах из Fraunhofer SIT и ATHENE. Работа опубликована как демонстрационная статья на конференции ICWSM 2026. Ниже русская редакционная версия материала с пояснениями к метрике влияния и ограничениям выборки. Я не запускал систему на другом массиве и опираюсь на статью, репозиторий и опубликованный набор данных.
Авторы не пытаются дать пользователю готовый ответ о Telegram. Они собирают в одном окне структуру пересылок, метаданные каналов и результаты анализа текста. Такой интерфейс рассчитан на исследователей и журналистов без опыта в машинном обучении. Он помогает найти вопрос для дальнейшей проверки, но не решает, какой канал распространяет ложь и как следует оценивать его содержание.
Граф вместо списка каналов
В исходном массиве находятся 995 публичных каналов и групп. Сообщения собирали через Telegram API с 25 марта 2022 года по 30 июня 2023 года. Состав выборки определяли вместе с журналистами и специалистами по проверке фактов: им были нужны заметные участники распространения дезинформации в Германии.
Из-за такого отбора набор нельзя считать уменьшенной копией всего Telegram. Он показывает конкретную исследовательскую область, сформированную экспертными интервью. Канал, который выглядит центральным внутри этого графа, может занимать совсем другое место за его пределами. Авторы прямо просят учитывать контекст выборки при интерпретации результатов.
Пользователь выбирает узел и видит связанные с ним каналы и группы. Пороговый фильтр убирает слабые связи, а отдельные фильтры оставляют входящие или исходящие пересылки. Справа появляется карточка с метаданными соседнего узла. Значения из верхнего дециля выборки выделены жирным, чтобы редкие показатели можно было заметить без ручного сравнения сотен карточек.
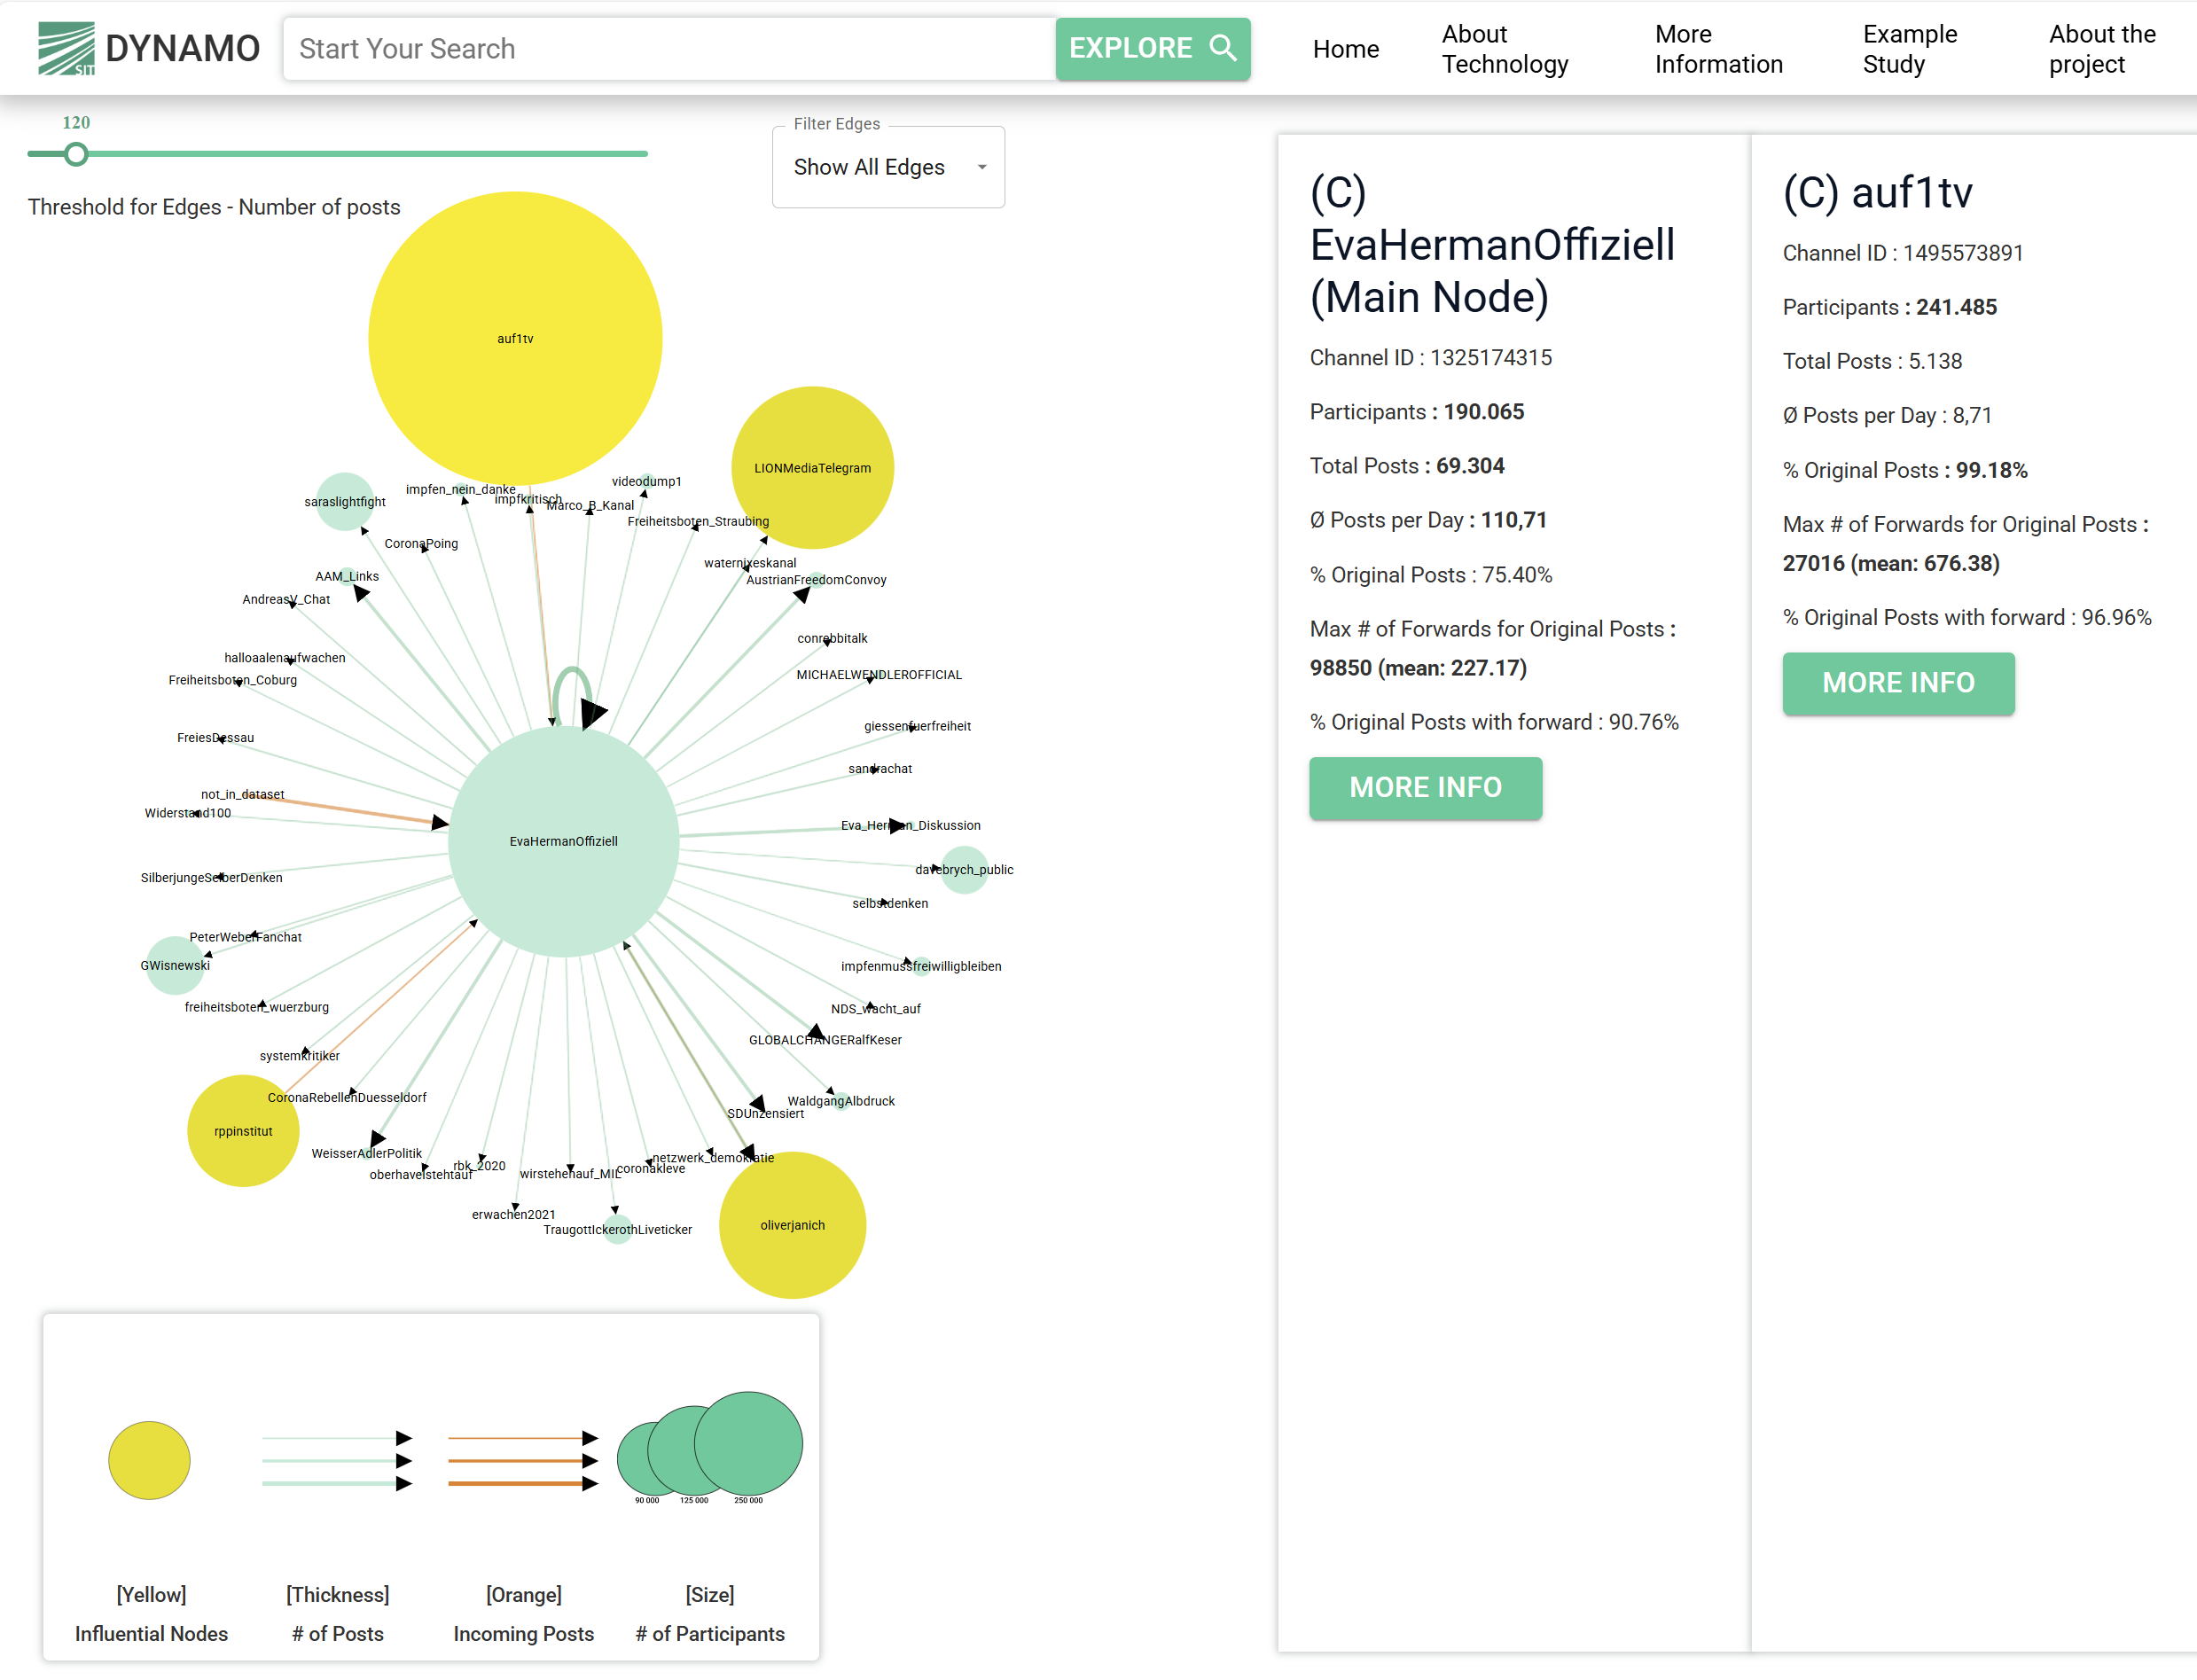
Если исследователь передаст собственные данные, демонстрацию можно развернуть локально. Авторы противопоставляют этот сценарий системам мониторинга соцсетей, которые следят за маркетинговыми показателями в реальном времени, а также инструментам, заранее настроенным на распознавание дезинформации. Здесь предмет исследования не зашит в классификатор. Пользователь сам выбирает участок графа и проверяет найденную связь.
Что авторы называют влиянием
Для каждого канала или группы авторы вычисляют собственную метрику влияния. В неё входят число участников, среднее количество публикаций в день, число оригинальных постов, которые пересылали, среднее количество их пересылок и доля сообщений, пришедших от каналов внутри набора.
В обозначениях статьи формула выглядит так: ψ + 0,8δ + 0,3(ω² × φ / число оригинальных постов) + 0,1μ. Здесь ψ означает число участников, δ среднее количество постов в день, ω число оригинальных постов с пересылками, φ среднее количество пересылок таких постов, а μ долю пересланных публикаций из исследуемого массива.
Узлы, которые система считает влиятельными, окрашены в жёлтый. Размер узла показывает число участников. Такое представление удобно для навигации, но сама формула остаётся исследовательским выбором. Она складывает аудиторию, активность и распространение постов с заданными авторами весами. Поэтому цвет узла говорит о результате этой конкретной метрики внутри выборки, а не доказывает влияние канала на общество.
В следующих версиях команда хочет добавить несколько способов измерения влияния, а не оставлять один итоговый показатель. Для исследовательского интерфейса это важнее красивого рейтинга: разные вопросы требуют разных определений центральности, охвата и распространения.
Как к графу добавили содержание
Кнопка More Info открывает пять основных тем выбранного канала или группы. Для тематического моделирования используется BERTopic, а тексты переводятся в векторное представление моделью all-MiniLM-L6-v2. Если публикаций слишком много, система случайно выбирает не более 10 000 сообщений. Тексты короче семи слов в этот этап не попадают.
Перед кластеризацией UMAP сокращает размерность векторов, затем HDBSCAN собирает похожие сообщения в группы. Для названия темы система берёт представительный пост кластера и передаёт его модели microsoft/Phi-3.5-mini-instruct. Полученная подпись помогает ориентироваться в интерфейсе, но не заменяет чтение сообщений: название строится по одному выбранному примеру и может упростить содержание кластера.
Для каждой темы интерфейс также показывает доли положительных, нейтральных и отрицательных сообщений. Поскольку большая часть корпуса написана по-немецки, авторы выбрали GermanSentiment. Эти значения описывают решение классификатора, а не эмоциональное состояние авторов постов. Их можно использовать, чтобы сравнить, как тексты разной тональности расходятся по графу, а спорные случаи придётся открывать и читать.
Связка графа и анализа текста позволяет искать каналы с похожими темами, смотреть, какие сюжеты преобладают, и прослеживать распространение сообщений с определённой тональностью. При этом в системе нет утверждения, что негативный текст ложный, а популярная тема важнее остальных. Она показывает вычисленные признаки рядом со связями и оставляет интерпретацию исследователю.
Где заканчиваются выводы
Демонстрация пока не работает в реальном времени. Подготовка полного массива объёмом 37,22 ГБ заняла около 15 часов, причём больше всего времени потребовало тематическое моделирование. Преобразование данных для интерфейса на React добавляет ещё несколько часов. Авторы считают, что параллельная обработка сократит ожидание, но в опубликованной версии это инструмент для заранее подготовленного исследования.
Система не отслеживает отдельных пользователей. В исходных данных они часто обезличены, а отказ от пользовательских профилей помогает сохранить границу приватности. Анализ строится вокруг каналов, групп и сообщений между ними.
Пользовательское тестирование пока было ограниченным. Команда планирует проверить интерфейс с другими исследователями и наборами данных, добавить фильтрацию по темам и тональности, выгрузку результатов, визуализацию близости тем и восстановление маршрута отдельных публикаций. Пока нельзя утверждать, что подход одинаково хорошо масштабируется на другие массивы или платформы.
Демонстрация не пытается быть автоматическим судьёй Telegram. Она разносит по разным слоям наблюдаемые пересылки, придуманную авторами метрику и выводы языковых моделей. По графу можно найти канал, который часто пересылают, а по карточке увидеть его основные темы и распределение тональности. После этого всё равно придётся открыть сообщения, проверить контекст и вспомнить, как была собрана выборка. Интерфейс сокращает путь до вопроса. Ответ авторы оставляют исследователю.