
Авторский разбор. Ссылки на материалы, использованные при подготовке, приведены в конце.
В коллаже Brain-IT легко узнать исходные сцены. Башня остаётся башней, жираф стоит на дороге, лыжник сохраняет позу и цвет одежды. Если смотреть быстро, подпись «чтение мыслей» кажется почти честной. Но этот эффект складывается из нескольких разных технологий, и мозг в них не хранит готовый JPEG.
Система получает данные функциональной магнитно-резонансной томографии человека, который в этот момент смотрит на изображение. Затем модель извлекает из активности мозга подсказки о содержании и композиции, а генератор собирает по ним новую картинку. Он может довольно точно вернуть общий сюжет, цвет и расположение объектов. Мелкие детали при этом не считываются. Их приходится правдоподобно достраивать.
Поэтому работу Brain-IT интереснее рассматривать как задачу перевода между двумя неполными представлениями. С одной стороны есть медленный и шумный сигнал fMRI. С другой находится пространство признаков моделей компьютерного зрения. Для меня главный результат исследования в том, что этот перевод научились переносить между разными людьми. Именно это сокращает персональную настройку системы.
Ниже я разбираю версию Brain-IT из препринта, обновлённого в марте 2026 года, и материалы, опубликованные исследователями к осени. Это эксперимент по реконструкции показанных изображений. Воображаемые сцены, воспоминания и сны авторы называют следующим направлением работы, но представленные результаты их пока не охватывают.
Почему данных мозга всегда мало
fMRI не фотографирует работу отдельных нейронов. Сканер отслеживает изменения кровотока и насыщения крови кислородом, связанные с активностью участков мозга. Измерение получается объёмным: каждый воксель объединяет сигнал от большого количества клеток. Даже в данных высокого разрешения между увиденным кадром и записью мозга остаётся большая дистанция.
Для обучения нужны пары из изображения и fMRI, снятого в тот момент, когда человек на него смотрел. Такой набор нельзя собрать привычным для машинного обучения способом. Участник лежит в томографе, сохраняет неподвижность и проходит много отдельных сессий. В использованном Natural Scenes Dataset было восемь участников. Каждый просмотрел тысячи изображений, а весь набор содержит около 73 тысяч пар изображения и fMRI.
Раньше модель обычно приходилось долго настраивать под конкретного человека. Анатомия и расположение функционально похожих зон различаются, поэтому простое объединение нескольких мозгов не даёт общего словаря. Для полноценной персональной модели использовали около 40 часов записей. Это дорого, тяжело для участника и плохо масштабируется даже внутри исследовательской лаборатории.
Команда Института Вейцмана пошла от функции вокселя, а не от его координаты. Сначала универсальный энкодер научился предсказывать реакцию каждого вокселя на изображение. Похожие реакции позволили собрать примерно 40 тысяч вокселей разных участников в 128 функциональных кластеров. Кластер может отвечать на определённую область кадра или визуальную категорию, даже если в двух мозгах его элементы находятся не в одинаковом анатомическом месте.
Эта общая карта и дала Brain-IT основу для переноса. При знакомстве с новым человеком большая часть модели остаётся замороженной. Дообучаются в основном представления его собственных вокселей, которые связывают индивидуальную запись с уже найденными функциональными группами.
Генератору нужны смысл и композиция
Один путь реконструкции предсказывает высокоуровневые признаки изображения. Они сообщают диффузионной модели, что в сцене есть жираф, человек или тарелка с едой. Этого достаточно для правдоподобной картинки, но недостаточно для совпадения. Генератор легко поставит нужный объект не туда, изменит ракурс или выберет другой цвет.
Второй путь отвечает за грубую структуру. Brain-IT предсказывает низкоуровневые признаки VGG, а метод Deep Image Prior превращает их в черновое расположение форм и цветов. Этот черновик становится начальной точкой диффузии. Семантическая ветка уточняет содержание, не начиная сцену с чистого шума.
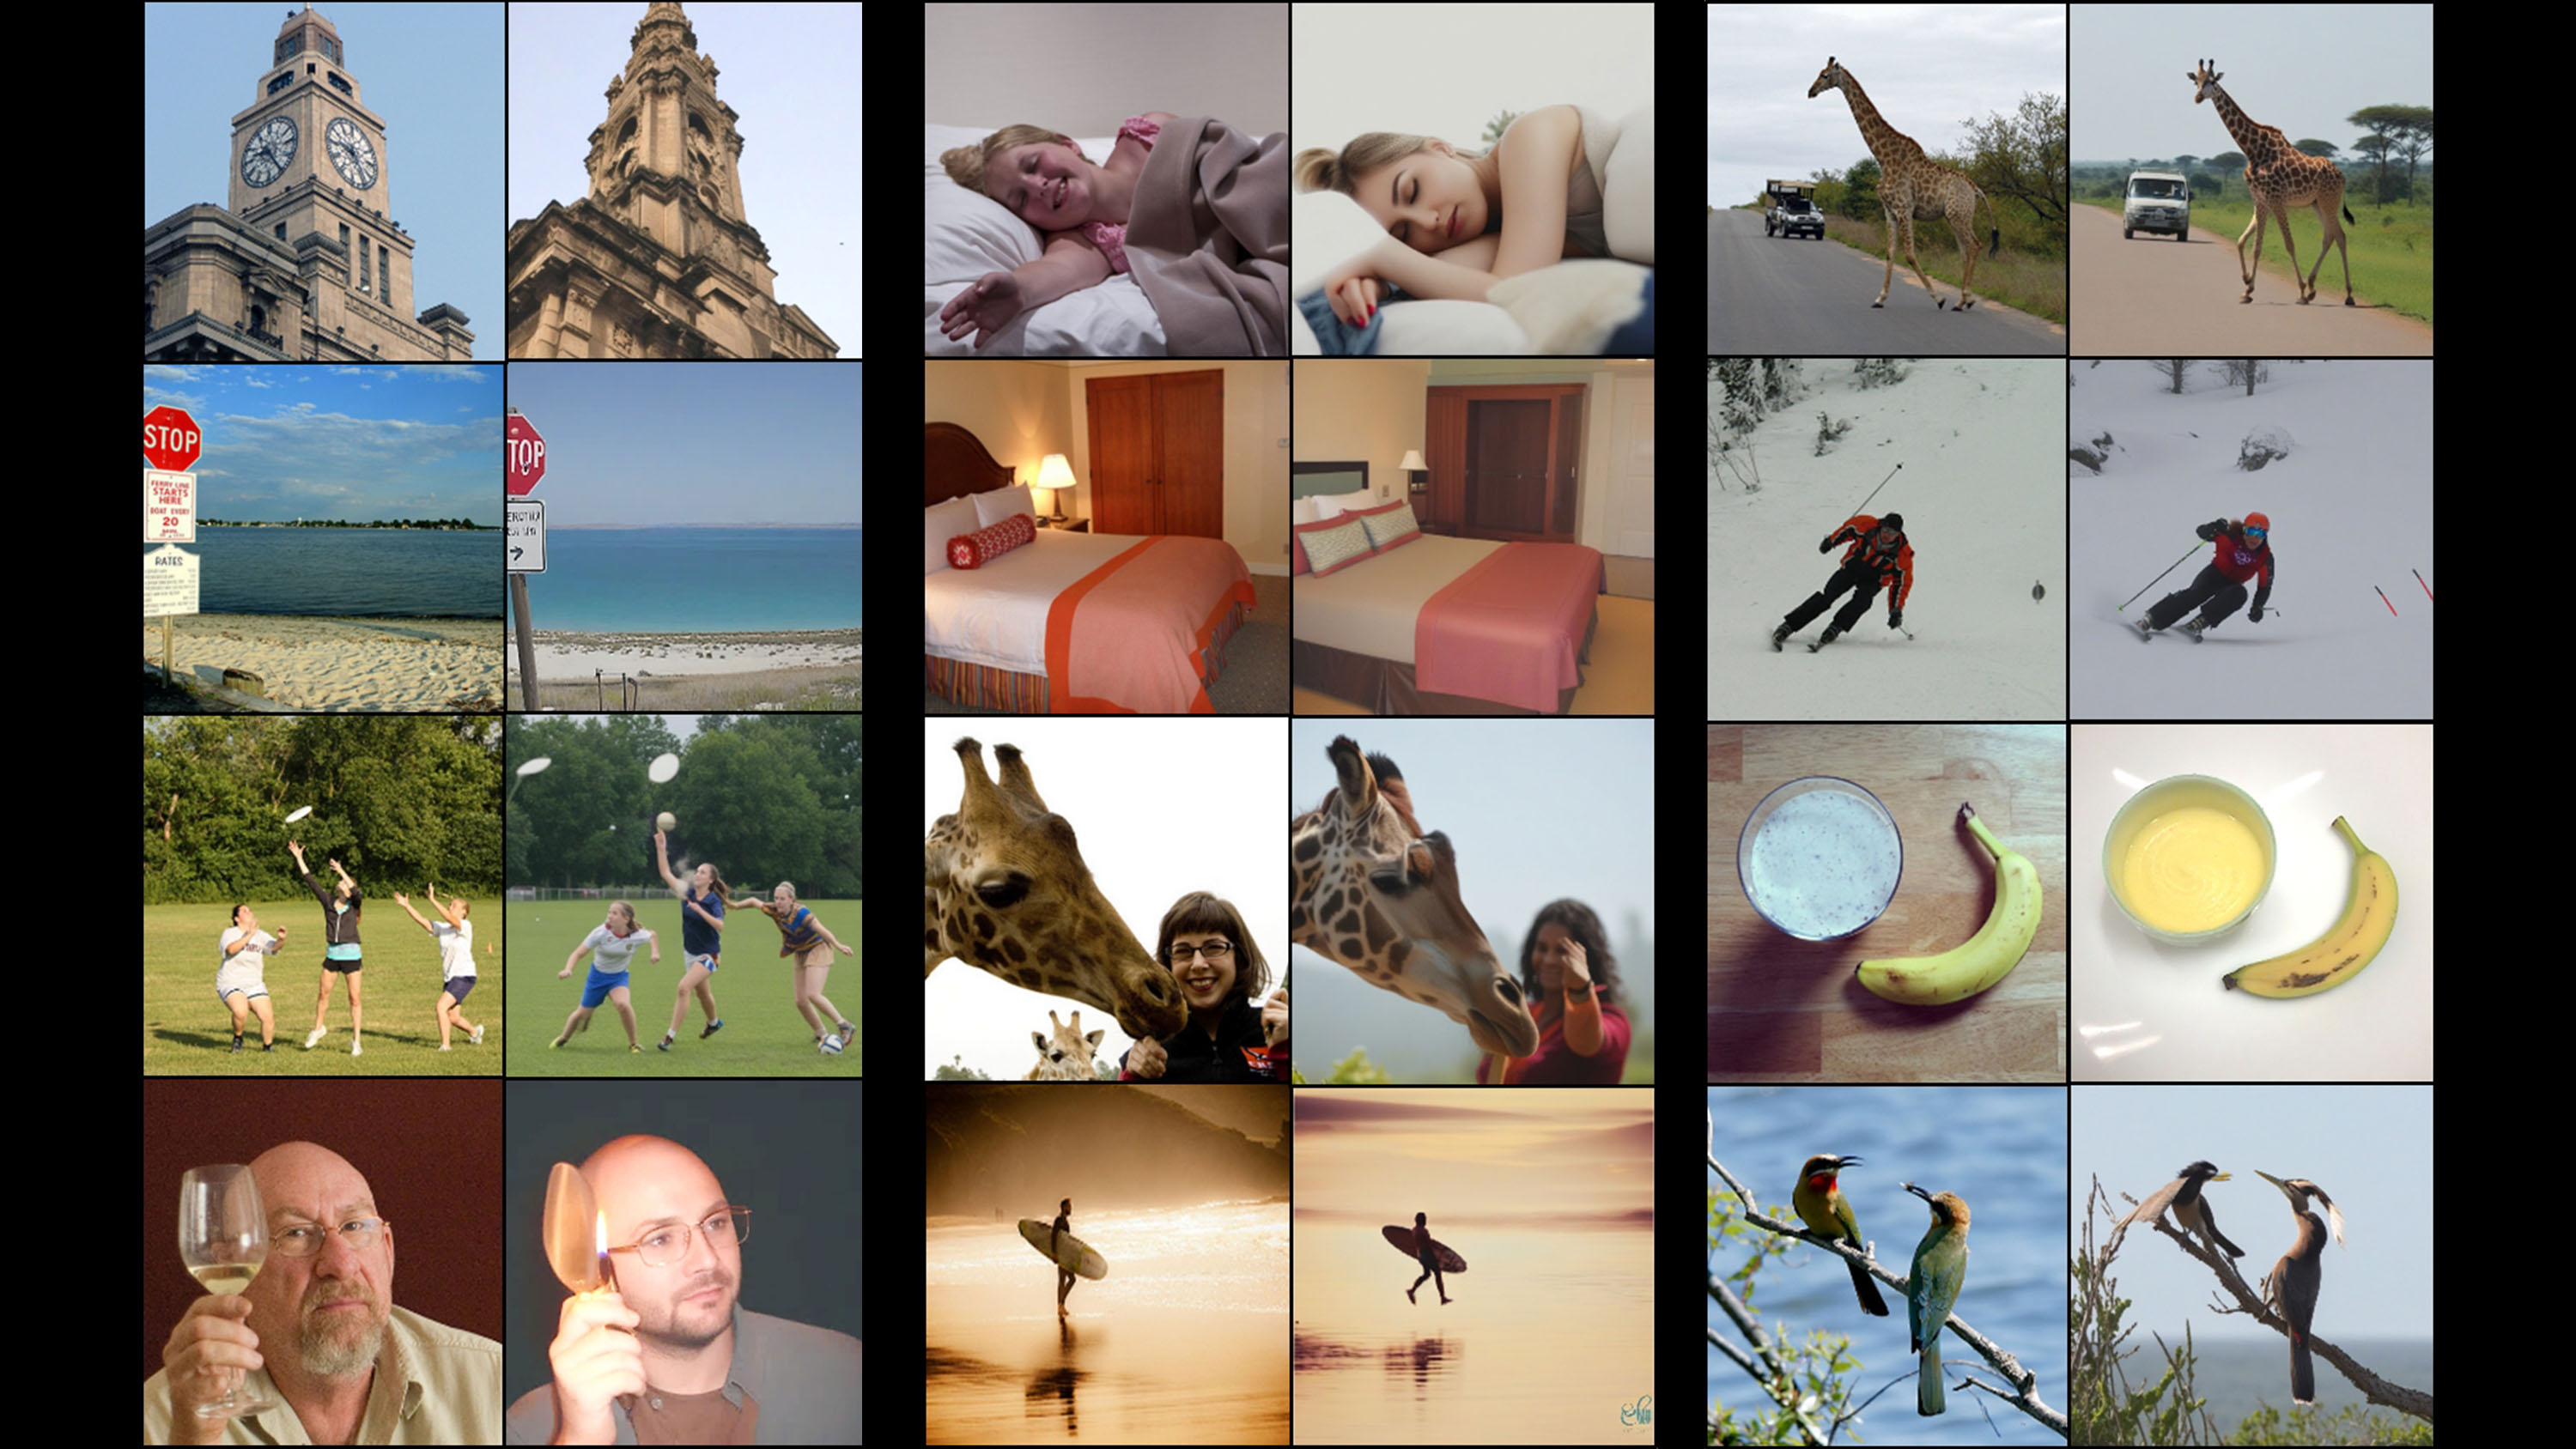
Коллаж хорошо показывает пользу двух веток. Модель удерживает крупные отношения внутри кадра: объект, фон, направление движения, доминирующие цвета. Но совпадение сюжета не превращает реконструкцию в копию. Лицо одного человека становится лицом другого, архитектура башни меняется, а отдельные птицы заменяются другими. В примерах неудач, которые исследователи показали журналисту MIT Technology Review, торт превратился в стопку сэндвичей, а собака в ванне стала козой похожего цвета.
Такие ошибки не случайный косметический дефект. Они показывают место, где измеренного сигнала уже не хватает и начинает работать априорное знание генератора о правдоподобных изображениях. Поэтому результат нельзя трактовать как визуальную запись из мозга. Это наиболее согласованная с сигналом версия, найденная моделью в пространстве знакомых ей картинок.
Что означает один час калибровки
В тестах на участниках Natural Scenes Dataset Brain-IT сравнили с предыдущими методами по метрикам структуры и семантического сходства. Полная версия показала лучший результат в большинстве использованных метрик. Более практичная часть эксперимента касается переноса: после одного часа данных нового участника Brain-IT оказался сопоставим с прежними моделями, обученными на полном наборе примерно из 40 часов.
Фраза «один час вместо сорока» требует аккуратности. Речь не о том, что любому человеку достаточно один раз надеть датчик и после этого система будет понимать его мысли. Модель заранее обучена на данных других участников и изображениях Natural Scenes Dataset. Новый человек всё равно проходит персональную калибровку в fMRI, а сравнение сделано в том же исследовательском наборе и по определённым метрикам.
В приложении к работе есть результаты для получаса и даже 15 минут данных. Авторы называют реконструкции осмысленными, но качество зависит от метрики и конкретного примера. Из этих результатов я бы оставил более узкий вывод: знания о функциональной организации нескольких мозгов помогают уменьшить объём новых записей. Это снимает часть главного ограничения подобных экспериментов, хотя не убирает томограф и контролируемый протокол.
Есть ещё один способ получить больше обучающих пар. Универсальный энкодер идёт в обратную сторону и предсказывает fMRI для обычной картинки, которую никто не видел в сканере. Brain-IT затем учится восстанавливать исходник по синтетическому сигналу. В работе для этого использовали около 120 тысяч дополнительных изображений COCO. Авторы отдельно проверяли вклад таких данных, но синтетическая запись остаётся предсказанием другой модели, а не новым наблюдением мозга.
Реконструкция не равна свидетельству
Слово «реконструкция» звучит так, будто система возвращает скрытый оригинал. В случае Brain-IT это опасная привычка языка. Выход зависит от обучающего набора, выбранных признаков, диффузионной модели и её представления о естественной картинке. Другая модель может построить иную сцену по тому же сигналу и сохранить при этом похожий общий смысл.
Для исследования восприятия это полезный инструмент. Можно проверять, какие функциональные группы реагируют на цвет, положение или категорию объекта, и сравнивать реакции разных людей. Но если такую картинку когда-нибудь попробуют использовать как подтверждение воспоминания, намерения или увиденного события, одной визуальной убедительности будет недостаточно. Рядом с результатом понадобятся исходный протокол, данные калибровки, версия модели, несколько возможных реконструкций и оценка устойчивости между запусками.
Текущий эксперимент далёк от скрытого наблюдения. Человек должен согласиться на долгую неподвижную съёмку в большом томографе и смотреть на изображения по заданию исследователей. Авторы и другие лаборатории уже изучают декодирование сигналов EEG, которые можно получать более компактными устройствами. Если подобный перенос между людьми заработает вне fMRI, вопрос согласия станет намного практичнее. Пока это направление работы, а не свойство Brain-IT.
Мне кажется важным сохранить эту дистанцию уже сейчас. Иначе красивый коллаж одновременно завышает возможности модели и мешает увидеть настоящее достижение. Brain-IT не достаёт картинку из головы. Он учится связывать индивидуальный сигнал с функциональными закономерностями, найденными у нескольких людей, а затем передаёт генератору достаточно структуры и смысла для узнаваемой версии увиденного.
Перенос между мозгами уже меняет практическую сторону исследования: новому участнику нужно заметно меньше времени в томографе. Свободные мысли система не читает, для такого вывода в работе нет данных. Зато как инструмент для изучения зрительного восприятия Brain-IT выглядит гораздо убедительнее собственного громкого прозвища.
Источники
- MIT Technology Review: репортаж о Brain-IT и комментарии исследователей
- Brain-IT: препринт с архитектурой, метриками, переносом и примерами ошибок
- Страница проекта Brain-IT с кодом и визуальными результатами
- Институт Вейцмана: описание исследования и Natural Scenes Dataset
- The Wisdom of a Crowd of Brains: универсальный энкодер для переноса между людьми